中国开源权重模型正在赢,西方闭源巨头该慌了
📅 2026年08月01日 · 前沿AI观察
2026年8月1日,硅谷的晨会上,某头部AI实验室的产品副总裁盯着最新的模型评测榜单,脸色铁青。榜单前十里,有四个名字来自中国,且全部是开源权重。他默默关掉屏幕,取消了原定于下午的“闭源模型生态壁垒”宣讲会。
这一幕,是我在过去三个月里从三位不同国家的从业者口中听到的真实碎片。当西方媒体还在用“抄袭”“落后”的旧剧本描摹中国AI时,一个不争的事实已经像潮水般漫过所有人的脚踝:中国开源权重模型策略,正在全球范围内赢得开发者、赢得企业、赢得市场,甚至赢得定义权。
这不是一次简单的技术追赶,而是一场关于AI民主化、关于地缘技术权力转移的范式级战争。今天,我想用最不留情面的笔触,把这场战争的中国战略、西方困境,以及我们每个普通开发者和企业该如何站队,掰开揉碎了讲清楚。
※ ※ ※
一、什么是“开源权重”?为什么这是中国最锋利的一把刀
首先,我们必须把这个概念从技术黑话里解救出来。所谓“开源权重”(Open-weights),指的是模型训练完毕后的神经网络参数文件(权重)被公开,任何人都可以下载、部署、微调,甚至商用。这与“开源代码”不同——你拿不到训练数据的配方和训练过程的代码,但你能拿到一个“完全属于你”的大脑。
这听起来似乎比OpenAI直接给API要“麻烦”一些。但正是这个“麻烦”,构成了中国AI军团最致命的杀伤力。
第一层杀伤力:私有化部署的绝对安全感。 我接触过不下二十家年营收过亿的制造企业和金融机构,他们不约而同地放弃了调用GPT-4或Claude的API,转而用DeepSeek或Qwen的开源权重模型跑在自己的服务器上。原因不是成本,而是恐惧——恐惧自己的经营数据、客户信息、未来战略,被作为“提示词”发送到一个位于加州的服务器上,成为别人模型迭代的养料。在中国开源权重模型面前,数据主权第一次真正回到了企业手中。
第二层杀伤力:极致的成本结构碾压。 当西方闭源模型还在按Token计费,试图维持高利润时,中国开源模型通过量化的MoE架构(混合专家模型),把推理成本打到了令人发指的低点。我见过一个真实的跨境电商业者,用一张4090显卡部署了Qwen-72B的量化版本,处理整个客服工单系统,每月电费不到100元人民币。这种成本结构,让“AI替代人力”从口号变成了连小作坊都能执行的算术题。
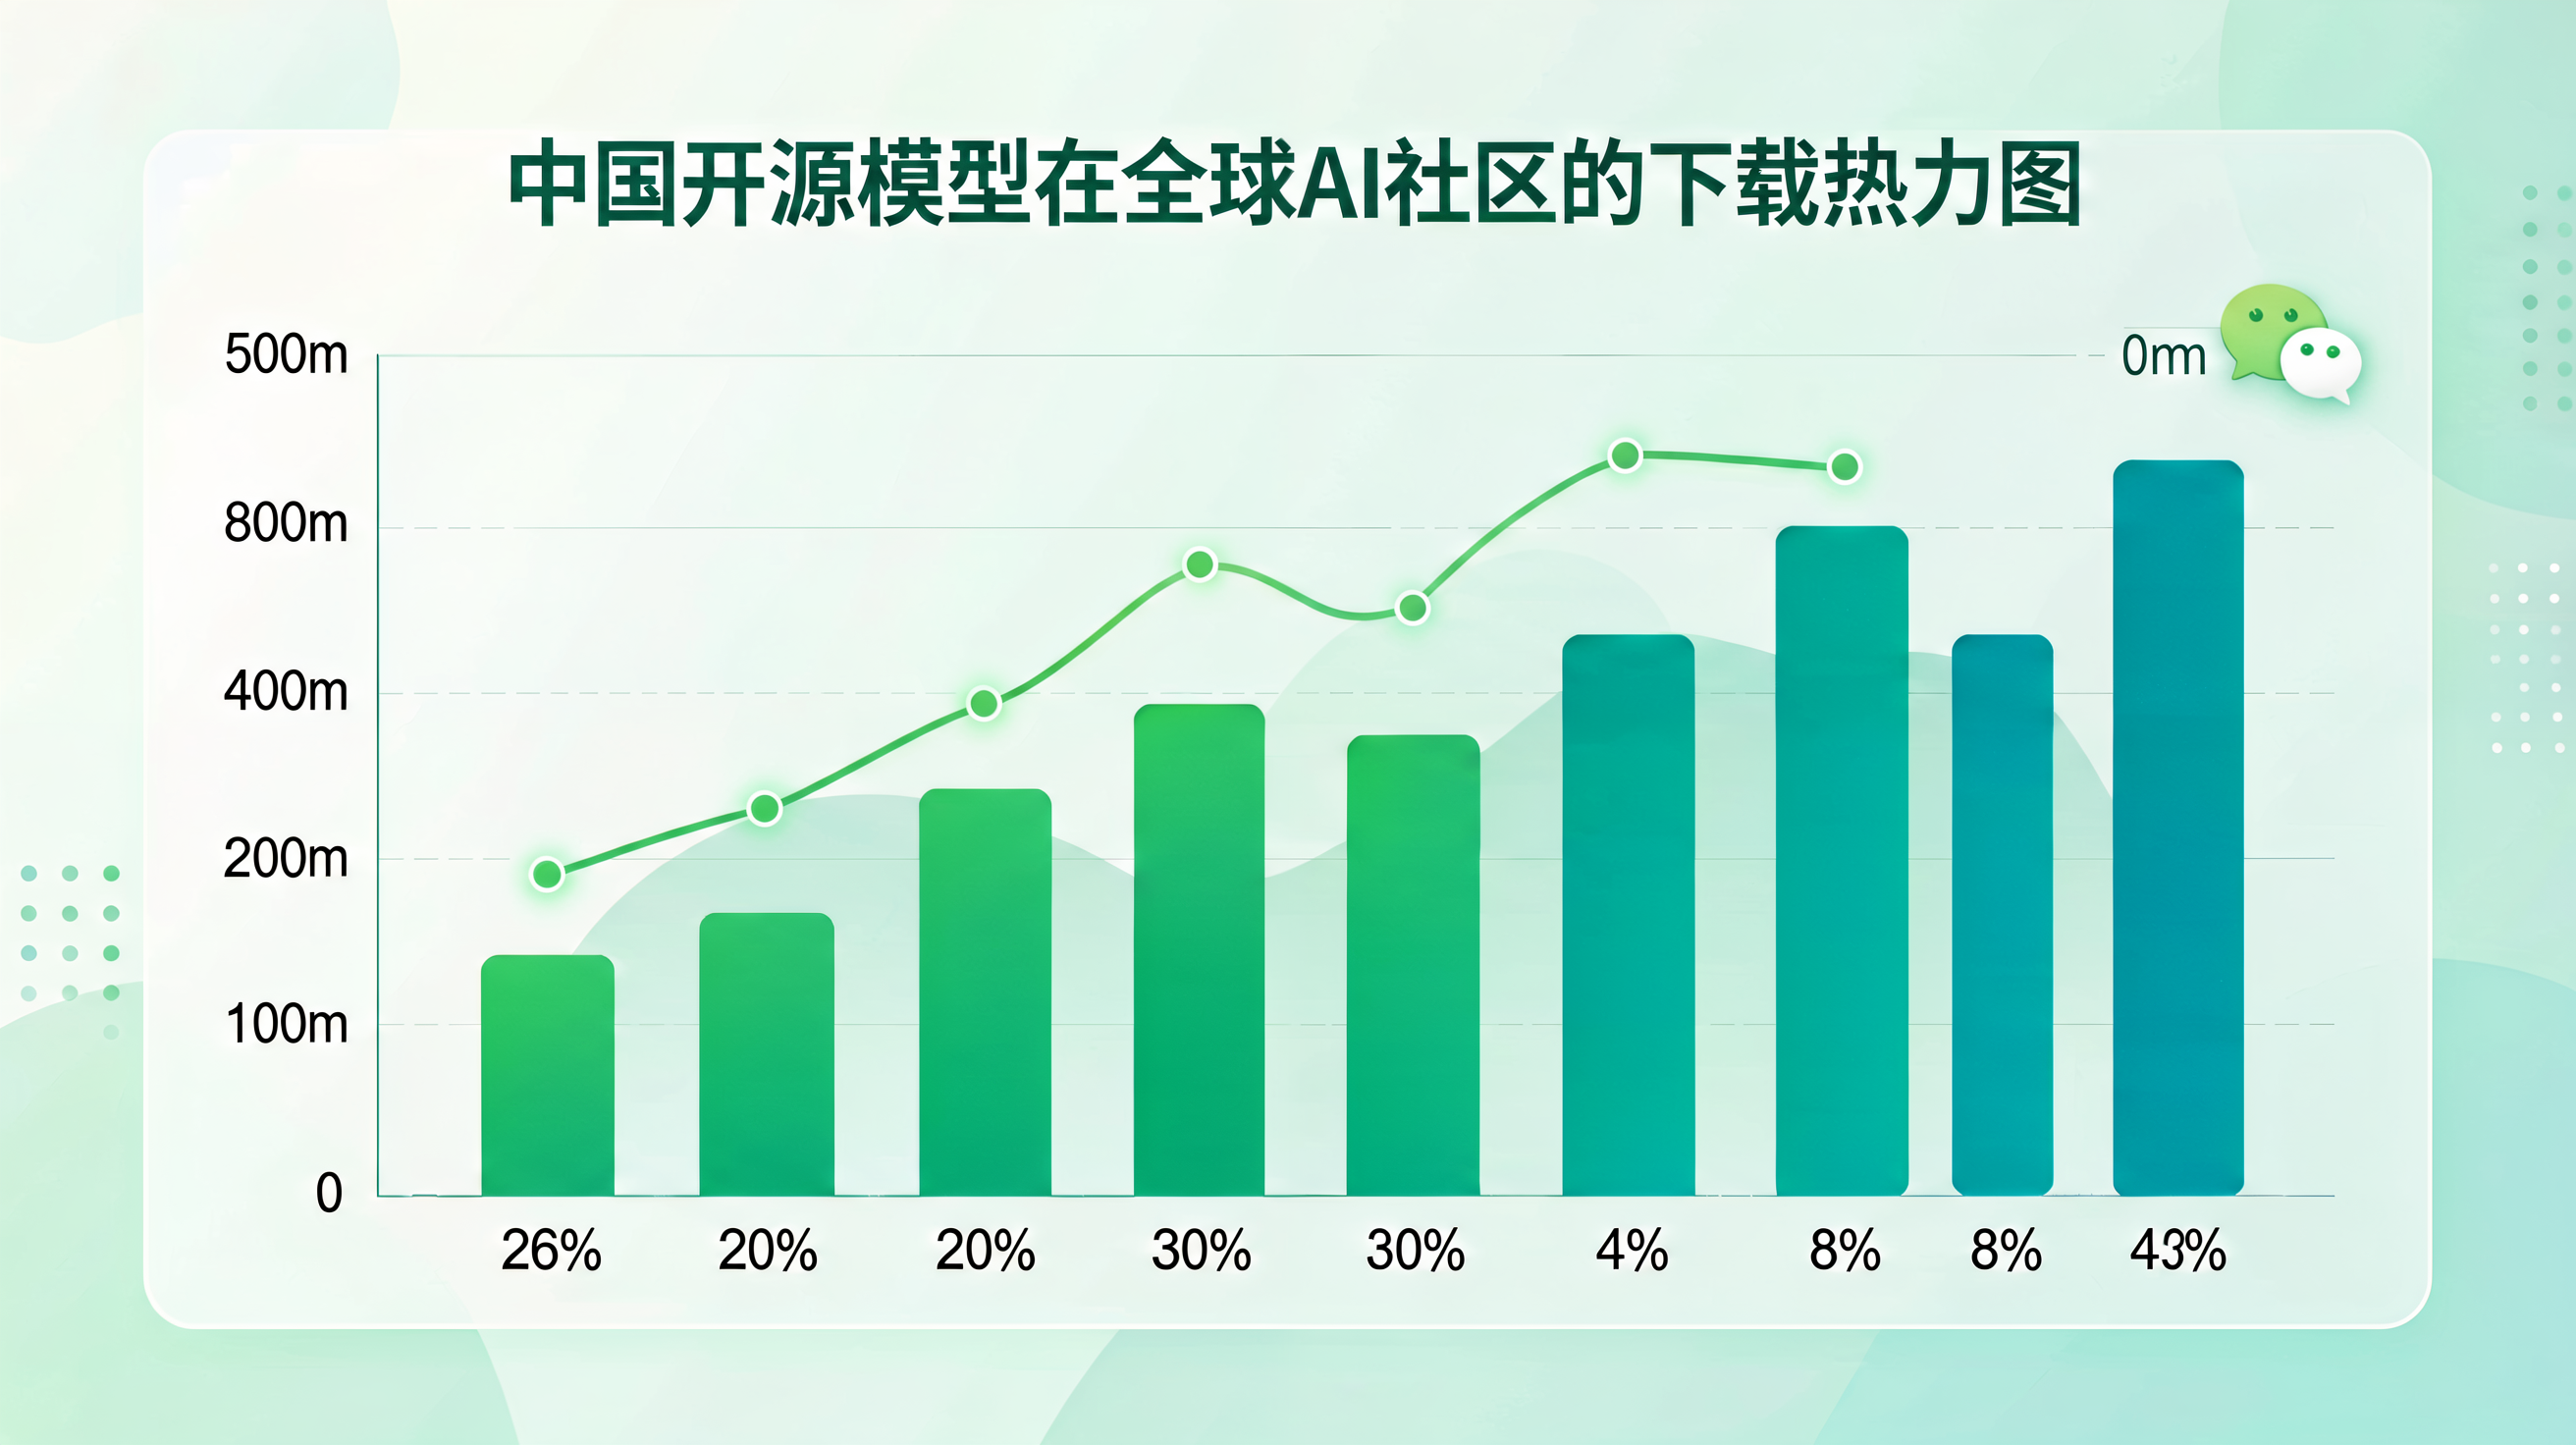
第三层杀伤力:生态的自我繁殖。 开源权重不只是模型,它是一种文化、一种宗教。当Meta的Llama还在纠结于“开放程度”时,中国的模型开发者们已经默认了“权重全给、商用免费、只保留归属声明”的激进策略。这种策略带来的结果就是,HuggingFace上的中文模型下载量,从2024年的不足三成,到2026年7月已经占据了半壁江山。全球的独立开发者、中小型SaaS公司,都在用中国模型做地基,搭建属于自己的AI大厦。
中国开源权重的胜利,本质上是“基础设施民主化”对“特权阶层垄断”的胜利。西方巨头用API构筑起了数字围墙,而中国用权重文件拆掉了这堵墙。
※ ※ ※
二、为什么闭源巨头正在“慢性失血”?从开发者叛逃说起
如果说上面是战略层面的描述,那么下面我想说几个血淋淋的微观案例。这些案例是我在最近几周与国内外开发者交流时,听到的最真实的“叛逃”心声。
案例一:欧洲某AI医疗创业公司的CTO告诉我,他们彻底删除了OpenAI的SDK。 原因有三:第一,GPT-4o的多模态能力虽然强,但医疗影像数据根本不允许上传到云端;第二,Claude的上下文窗口虽大,但针对德语和法语的医疗术语微调,闭源模型根本不给底层访问权。他们最终选择了智谱的GLM-4.6开源权重版本,在AWS欧洲区租了几台GPU机器,用LoRA微调了三天,模型在专业术语上的准确率直接提升了12%。他最后说了一句话:“闭源模型给我的是鱼,开源权重给我的是渔网和鱼竿,而中国公司甚至把渔船都给我造好了。”
案例二:国内某头部量化私募的算法工程师,跟我透露了一个细节。 他们用DeepSeek-V3的开源权重搭建了高频交易辅助决策系统。由于权重完全掌握在自己手里,他们可以对模型的注意力头进行极限压缩,把推理延迟从40毫秒降到了8毫秒。这32毫秒的差距,在毫秒必争的金融市场里意味着数千万的利润差异。如果用闭源API,延迟是不可控的,商业模式随时可能被上游厂商的一纸公告击穿。
案例三:更讽刺的是,连OpenAI自己的员工都在私下用中国开源模型。 上个月我在一个技术酒会上,遇到一位刚从OpenAI离职的华人研究员。他说,内部很多工程师在做一些“非核心”的预研项目时,根本不想排队等待内部算力配额,而是直接去HuggingFace拉一个Qwen模型的权重,在自己笔记本上跑实验。他说:“这就像你在微软工作,但写个人博客时还是习惯用Google Docs一样。效率是人性,挡不住的。”
闭源巨头的困境在于,他们试图用“安全”和“质量一致性”作为护城河,但在这个速度至上的时代,开发者更在意的是“可控性”和“自由度”。当中国开源模型的平均能力已经达到闭源模型95%的水平,而成本只有其10%时,那5%的差距,根本不足以阻止理性的开发者的脚步。
※ ※ ※
三、算力封锁失效了吗?中国开源策略的“隐形突围”
很多人会问:美国不是在限制高端GPU出口吗?为什么中国AI还能发展这么快?这恰恰是这次热点话题里最值得玩味的战略纵深。
中国开源权重模型的爆发,本质上是一次对算力封锁的教科书式降维打击。既然买不到最先进的H100,那我就把模型架构的“贫民化”做到极致。DeepSeek的MLA(多头潜在注意力)架构,以及MoE的极致稀疏化,让训练和推理所需的算力呈现指数级下降。他们用3.2T的Token在2048块H800上训练出了性能对标GPT-4的模型,这本身就是一种技术奇迹。
更重要的策略是“算法换算力”。中国团队不搞暴力美学,不追求堆算力堆参数,而是把精力放在数据清洗、课程学习、强化学习对齐上。比如开源模型在代码生成和数学推理上,通过大规模使用可验证的奖励模型(RLVR),让模型在极少的人类反馈下自我进化。这种策略使得模型在逻辑推理能力上突飞猛进,而消耗的算力却远小于传统方法。
这种“开源社区+低成本算力+极致算法优化”的三位一体,直接击穿了美国“算力禁运”的城墙。因为,你无法封锁一个不依赖最先进制程芯片就能运行的算法。当中国开源模型可以在消费级显卡上流畅运行,并且性能足以满足大部分生产需求时,封锁的意义就只剩下了政治作秀。
※ ※ ※
四、实战落地:如何用中国开源权重模型武装你的业务?
讲了这么多宏观叙事,如果你是一位技术决策者或开发者,最关心的肯定还是那句“这跟我有什么关系”。关系大了。你不必再忍受闭源API的“卡脖子”,也不必再为高昂的Token费用失眠。下面我给出一个具体的、可落地的行动框架,以及一段能直接运行的代码,让你在20分钟内感受到“权重在手,天下我有”的掌控感。
第一步:选型。 如果你需要英文能力最强且指令遵循极佳,选DeepSeek-V3.1;如果你需要中文深度理解和多轮对话,选Qwen3-72B;如果你需要长文本处理,选Yi-1.5-34B(200K上下文)。别犹豫,直接去ModelScope或HuggingFace下载。
第二步:部署。 如果你没有GPU服务器,用vLLM或SGLang在云上部署。但如果你有哪怕一张3090或4090显卡,我强烈建议你用Ollama跑本地版,体验那种“数据不出门”的踏实感。
第三步:微调与集成。 这是开源权重的灵魂。下面这段代码,展示了如何用 LLaMA-Factory 这个国产神器,在5分钟内在你的本地数据上微调Qwen模型,让它变成你的专属客服:
# 环境准备: pip install llama-factory
import os
os.environ["CUDA_VISIBLE_DEVICES"] = "0"  # 指定GPU

from llama_factory import create_webui

# 配置微调参数(以LoRA为例)
config = {
    "model_name_or_path": "Qwen/Qwen2.5-7B-Instruct",
    "stage": "sft",
    "finetuning_type": "lora",
    "dataset": "my_custom_chat_data.json", # 你的专属对话数据
    "template": "qwen",
    "lora_rank": 64,
    "learning_rate": 1e-4,
    "num_train_epochs": 3,
    "output_dir": "./my_qwen_advisor",
}

# 启动训练
trainer = create_webui(config)
trainer.run()

# 训练完成后,加载微调后的模型进行推理
from transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("./my_qwen_advisor").to("cuda")
tokenizer = AutoTokenizer.from_pretrained("./my_qwen_advisor")

# 你的专属AI顾问
prompt = "请根据我们公司过去三年的销售数据,分析下一季度的市场策略。"
inputs = tokenizer(prompt, return_tensors="pt").to("cuda")
outputs = model.generate(**inputs, max_new_tokens=512)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
看到没?没有API密钥,没有网络延迟,没有内容审核屏蔽。你买到的不是一个“用别人数据的AI”,而是一个“长在你业务血肉里的数字员工”。 这种深度定制能力,是闭源API永远给不了你的。
※ ※ ※
五、未来终局:开源权重如何重塑全球AI权力版图?
站在2026年8月1日的节点,回望过去两年,中国开源权重的胜利不是偶然,而是战略定力与工程智慧的必然。但更大的风暴还在酝酿。
未来十二个月,我预测会发生三件事: 第一,中国将出现一个“开源模型标准委员会”,统一推理接口、微调范式和评测基准,让全球开发者真正实现“一次编写,处处运行”;第二,西方闭源巨头将被迫开放权重,但会加上“桌面端免费、云端商用收费”的复杂条款,这将进一步激怒开发者社区;第三,基于开源权重的端侧AI(手机、PC、汽车)将迎来爆发,因为高通和联发科的芯片跑中国模型如鱼得水,而跑GPT-4级别的模型则寸步难行。
这场战争没有旁观者。 如果你还在一味崇拜闭源巨头的“神谕”,你可能正在失去对技术栈的掌控权。而聪明的玩家,已经开始把中国开源权重模型训练成自己的得力干将。
最后,给你三个可执行的行动建议,别光看热闹:
- 本周末,用Ollama在你的电脑上跑通一个Qwen3-7B或DeepSeek-R1-8B模型。 体验一下离线推理的极速感,试着让它帮你写一封邮件或总结一篇研报。感受那种数据不被窥探的自由。
- 盘点你业务中“数据敏感但价值高”的场景。 比如法务合同审查、内部知识库问答、供应链预测。列一个清单,评估哪些可以用开源权重模型私有化部署来解决。别再让核心数据流向外企的API了。
- 去ModelScope社区,找一个你所在行业的数据集。 哪怕只有几百条对话记录,尝试用上面代码做一次LoRA微调。你不需要成为算法专家,只需明白“投喂专业数据”这个动作本身,就能让你的AI比通用模型强出一个量级。
中国开源权重的浪潮已经漫过了堤坝,它不是要淹没谁,而是要让每一个普通的开发者,都拥有造一艘方舟的能力。你,上船吗?
评论 (0)
登录 或 注册 后参与讨论。