记忆战开打了:84 分卷子复测成 58,你的 AI 记忆是个漏水的桶
写这篇稿的今早 5 点,我那台自托管的记忆服务在崩溃循环里躺了四十分钟:systemd 重启计数器跳到 13,每次都在启动超时后死掉。查下去原因令人无语——数据库配置文件里写了一个系统没生成的中文 locale,postgres 直接 FATAL,而外层服务只看见“120 秒内起不来”。
一条 locale-gen 修好了它。但这个事故恰好给今天的主题做了开场白:你以为给 AI 装记忆是“装个插件”,实际是给自己揽了个运维岗。
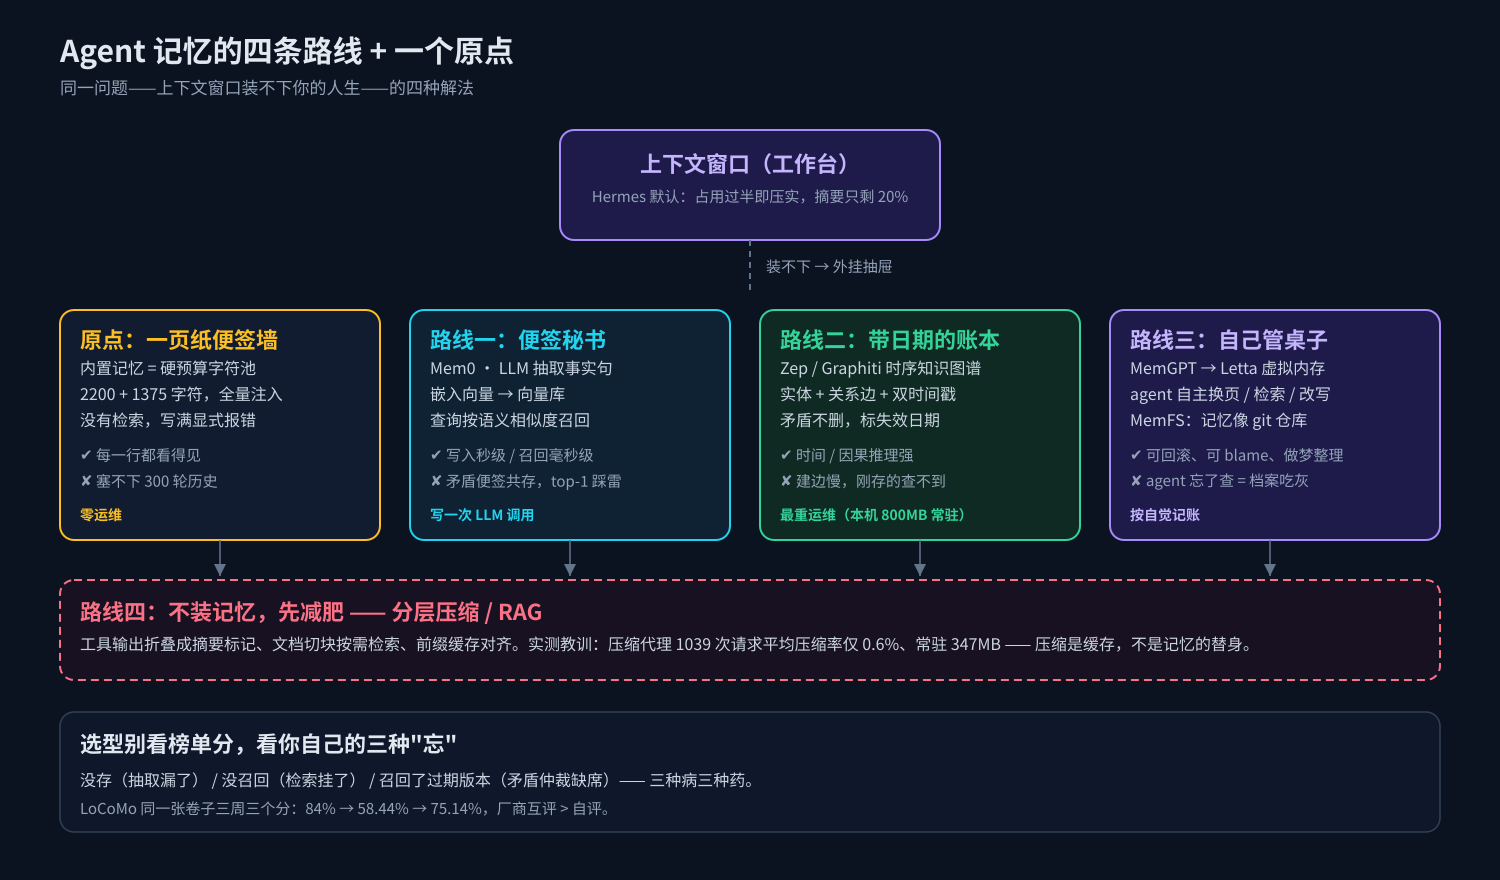
这篇把市面上四条 agent 记忆路线摆开:向量提取存储、时序知识图谱、agent 自管理、分层压缩。论文数字、公开对线记录、外加我今早在一台 4GB 内存云服务器上的实测,一起过一遍。先说结论:没有哪条路线配得上各家宣传的“过目不忘”,但差距不在准确率,在别的地方。
※ ※ ※
先搞清楚:你的助手为什么会“转头就忘”
大模型的原始记忆只有一份:上下文窗口。窗口是固定的,对话越长,早期内容占比越低,一旦超过阈值,agent 框架就会动手——要么截断,要么压缩。
拿我天天用的 Hermes 来说,翻源码能看到它的真实参数:上下文占用超过窗口的 50%(agent_init.py 里的默认 threshold)就触发压实(compaction),把旧对话压成一份摘要,摘要预算只有原文的 20%(context_compressor.py 里的 _SUMMARY_RATIO = 0.20)。也就是说,你聊到一半,助手做了一次“脑内小手术”:五分之三的细节永远没了,剩下的还得过一道 LLM 转写的失真。
这就是“转头就忘”的第一性原因:窗口不是记忆系统,是工作台。 桌面上堆不下的东西,要么扔进抽屉(外部记忆),要么烧掉(压实)。所有记忆方案的争论,本质上都是抽屉该怎么做。
一句话:你的助手不是记性差,是你的桌面上根本就没给它留记账的地方。
※ ※ ※
路线一:便签秘书 —— Mem0 的向量提取存储
Mem0 的思路简单直白:每轮对话结束后,请一个 LLM 当秘书,把值得记的事撕成一条条“便签”(自然语言事实句),嵌成向量存进向量库;下次聊天前,按语义相似度捞最相关的几条塞回提示词。
这是目前开源界装机量最大的路线。2025 年 4 月他们发了篇论文(arXiv:2504.19413),报了一组很能打的数字:在 LoCoMo 基准上,LLM-as-a-Judge 口径比 OpenAI 的记忆方案相对提升 26%;比“全量上下文硬塞”的做法省 90% 以上的 token 开销,p95 检索延迟低 91%。
论文里的机制描述还有一层:新便签入库前,秘书会先检索一遍旧便签,遇到矛盾就发 UPDATE 或 DELETE,不是无脑堆 ADD。这个细节一会儿实测要考。
※ ※ ※
路线二:带时间戳的账本 —— Zep 与时序知识图谱
Zep 嫌便签太碎,主张记账要记“关系”:把对话和系统数据实时抽取成实体和边,构成一张知识图谱(核心引擎叫 Graphiti),每条事实带双时间戳——什么时候发生的、什么时候被系统得知的。当新事实与旧边矛盾时,旧边不删除,而是标记失效日期。
一句话:便签簿记“他现在住哪”,账本记“他 8 月起从杭州搬到成都,之前住杭州”。时间推理和因果链是图谱路线的主场。
论文(arXiv:2501.13956)给的数字:DMR 基准 94.8%,赢了 MemGPT 自己报的 93.4%;LongMemEval 上准确率提升最高 18.5%,同时比全上下文基线降 90% 延迟。
※ ※ ※
路线三:自己管桌子的 agent —— MemGPT 与 Letta
第三条路线根本不做“外部抽屉”,而是让 LLM 自己当图书管理员。MemGPT 的论文(arXiv:2310.08560)借了操作系统的一个老点子——虚拟内存:把上下文窗口当内存,把外部存储当磁盘,agent 通过函数调用主动在两层之间换页,需要什么就自己去档案库里查什么。
这套思想现在长在 Letta 里。今年他们又往前拱了一步:新 Agent SDK 把记忆系统做成 MemFS——一个 git 跟踪的文件系统,agent 的记忆像代码仓库一样有版本、可回滚,外加一个“做梦”机制(dreaming),空闲时对记忆做后台整理。
一句话:前两条路线是外包记忆公司,这条是让助手自己记日记、自己归档,还带版本控制。
※ ※ ※
反方向的最小主义:一张 2200 字符的便签墙
在拆四条“外挂”路线之前,值得先看一眼不装任何系统时的极限能做到什么。Hermes 的内置记忆是我最长时间依赖的方案,它的源码里写着全部设计哲学:两个记忆池——事实池 2200 字符、用户画像池 1375 字符(tools/memory_tool_store.py 的默认值,可通过配置放大),条目用分隔符拼接,每次会话开场原样注入系统提示词,不走任何检索。
对,没有向量库、没有嵌入模型、没有 LLM 抽取,就是写死在提示词前言里的一页纸。它把“忘”的决策权直接交给了预算:装不下了,写工具当场拒绝,报“memory is full”,逼着 agent(或背后的你)做一次显式的删改。我的事实池现在就顶着配额跑,每天凌晨有个归档任务把低频条目搬进外部记忆、再从池子里删掉——听起来简陋,但这套机制对“记错”的免疫力反而最强:那页纸上的每一行你都看得见,过期了就是你没删,不存在“召回了 top-1 旧地址”这种事。
适用边界同样清楚:一页纸塞不下 300 轮对话的历史,它记得了“用户偏好简洁回复”,记不了“三周前的周二下午他说过什么”。它是路线图上的原点——所有外挂记忆,都是这页纸写满之后的妥协。
※ ※ ※
路线四:不装记忆,先减肥 —— 分层压缩
还有一条常被忽略的路线:与其外挂记忆,不如把上下文本身省着用。RAG 把文档切成块按需检索,上下文压缩层把动辄几 KB 的工具输出折叠成摘要标记,需要时再展开。我本机对这条路线有过一段血泪账:去年给网关挂过一个压缩代理,跑了 1,039 次请求后拿 /stats 一对账,平均压缩率只有 0.6%,省下的 token 折合不到一毛钱,常驻内存却吃掉 347MB,每请求还多花约 500ms。卸了。
教训:压缩不是记忆的上位替代,是缓存。前缀缓存对齐省的钱,实测比压缩本身多两个数量级。
※ ※ ※
实测:在一台 4GB 云服务器上跑 Mem0,翻车翻在论文承诺的地方
空口对比没意思,我今早把 Mem0 开源版(mem0ai 2.0.10)在本机跑了一条最小管道:LLM 走一个 Anthropic 兼容端点,嵌入模型用 fastembed 的本地小模型(BAAI/bge-small-en-v1.5,384 维,不依赖任何云端 API),向量库用 qdrant 的本地文件模式——全套零外部依赖,你的笔记本就能复现:
import os, yaml
from mem0 import Memory

# LLM 后端换成任意 Anthropic 兼容端点即可
KEY = os.environ["LLM_API_KEY"]
BASE = os.environ["LLM_BASE_URL"]

m = Memory.from_config({
    "vector_store": {"provider": "qdrant", "config": {
        "path": "/tmp/mem0_demo_qdrant",
        "collection_name": "demo",
        "embedding_model_dims": 384,
    }},
    "llm": {"provider": "anthropic", "config": {
        "model": "your-model", "api_key": KEY,
        "anthropic_base_url": BASE, "max_tokens": 2048,
    }},
    "embedder": {"provider": "fastembed",
                 "config": {"model": "BAAI/bge-small-en-v1.5"}},
    "history_db_path": "/tmp/mem0_demo_history.db",
})

# 场景一:第一次会话,写事实
m.add([
    {"role": "user", "content": "我是素食主义者,对贝类过敏,住在杭州。"},
    {"role": "assistant", "content": "收到,已记下你的饮食偏好。"},
    {"role": "user", "content": "我最喜欢的语言是 Rust,缩进用 tab。"},
], user_id="alice")
# → 抽取结果(9.3 秒):
#   User is vegetarian and allergic to shellfish.
#   User lives in Hangzhou.
#   User's favorite programming language is Rust and prefers tabs over spaces.

# 场景二:"隔了一个月",说矛盾的新事实
m.add([
    {"role": "user", "content": "其实我上个月搬到成都了,最近也开始吃鱼了。"},
], user_id="alice")

# 场景三:召回
for hit in m.search("Alice 住哪?吃什么?",
                   filters={"user_id": "alice"}, top_k=4)["results"]:
    print(hit["memory"])
先说顺的部分:三条事实的抽取干净利落,一次 add 9.3 秒,全在本地+一个国产端点上完成;search 只花 0.01 秒(不含 LLM 生成),语义召回对“做饭建议”这种间接提问也能命中过敏原,这是向量路线的基本盘,确实稳。
然后是翻车现场。场景二的 add 返回的事件是两条 ADD——不是论文里承诺的 UPDATE:
('ADD', 'User moved to Chengdu around August 2026.')
('ADD', 'User has recently started eating fish ... changing from
        their previously stated vegetarian preference.')
再看最终库存,五条记忆,新旧同穴而居:
User lives in Hangzhou.                                    ← 过期的
User is vegetarian and allergic to shellfish.              ← 半过期的
User moved to Chengdu around August 2026.
User has recently started eating fish ...
User's favorite programming language is Rust ...
最要命的是场景三的召回排序:问“Alice 住哪”,返回第一名赫然是 “User lives in Hangzhou”。新记忆也在列表里,但按相似度它排在旧记忆后面。也就是说,如果你的 agent 只捞 top-1,它会信心满满地告诉你一个一年前的地址,还引用得掷地有声。
这不是配置错误——默认提示词、默认流水线、官方 README 的用法。论文里那个“检索旧便签→决定 ADD/UPDATE/DELETE”的仲裁环节,在 base 版实测里没有触发,矛盾便签就这么平铺在抽屉里。原因不难猜:仲裁靠 LLM,多一轮检索加一轮判断就是多一倍延迟和费用,默认链路选择了快,把准确性让给了调用方自己管。
一句话:便签秘书只负责记,不负责改。“转头就忘”解决了,“越记越乱”新来了。
同一台机器上,我的 Hindsight 0.8.6(一条带实体图谱的记忆服务,路线一和路线二的混血)今早恢复后也测了一把:retain 一条三事实的句子花 14.8 秒——贵在它后台真的做了实体抽取和关系建边,写路径比 Mem0 更重;但 recall 只要 0.27 秒,返回的不再是原句,而是拆碎的事实单元,每条挂着实体标签:
Bob is a vegetarian. | Involving: Bob
Bob lives in Hangzhou. | Involving: Bob
Bob switched to remote work in July 2026. | Involving: Bob
时间事实(“2026 年 7 月起远程办公”)被单独成分片,这是图谱路线对时间推理该有的样子。代价写在 systemd 的账上:这个服务常驻 RSS 800MB,启动 60 秒起步,峰值 845MB——对一台 3.6GB 可用的机器来说,一个记忆服务占到内存的四分之一,还今早给我演示了一遍什么叫崩溃循环。
※ ※ ※
基准测试战争:同一张卷子,三个分数
如果上面的实测让你觉得 Mem0 宣传过头了,接下来这段会让你对所有厂商的数字都免疫。
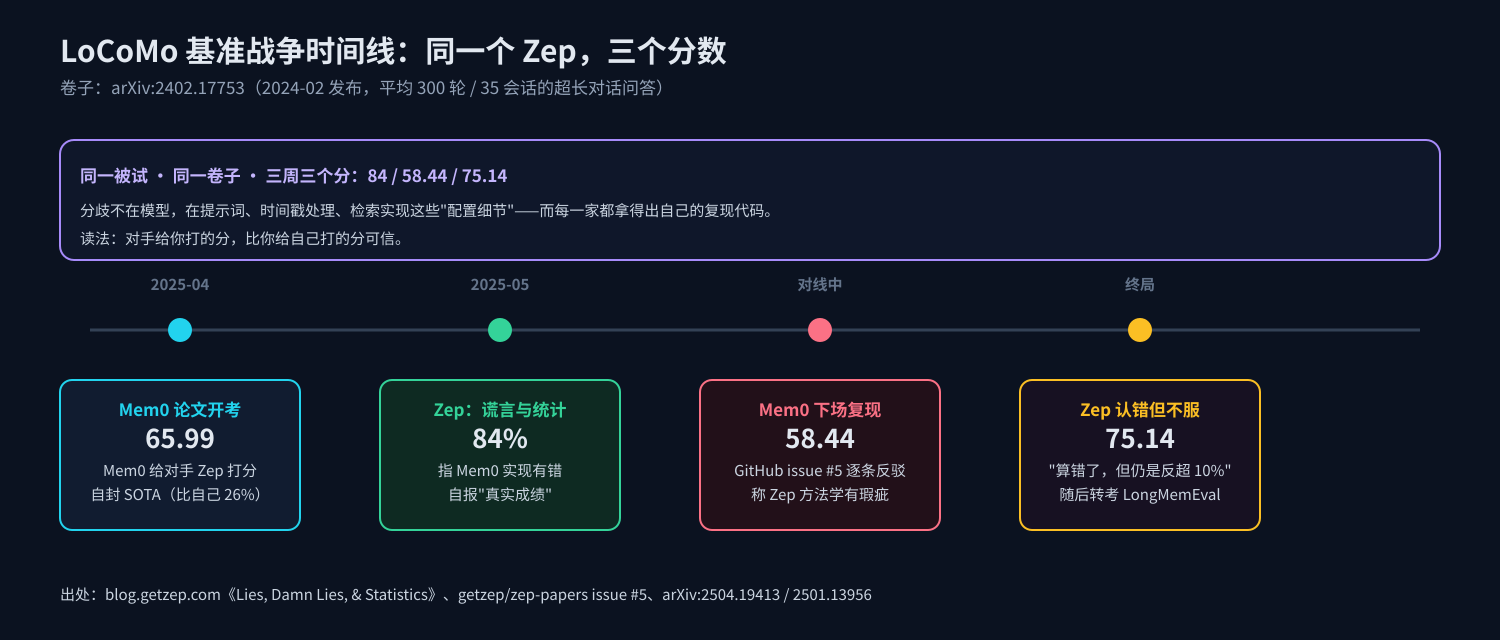
LoCoMo 是 2024 年 2 月放出的长对话记忆基准(arXiv:2402.17753):每条对话平均 300 轮、9K token、跨 35 个会话,题目考的是几千轮之后你还记不记得第一周谁说了什么。它几乎是目前唯一的公开横评战场,然后它变成了一片公共坟场:
- ▪ 2025 年 4 月,Mem0 论文里把 Zep 判了 65.99 分;
- ▪ 同年 5 月,Zep 发博《谎言、该死的谎言与统计数字》,称 Mem0 的实现有错,自家真成绩约 84%;
- ▪ Mem0 联合创始人下场在 GitHub 复现 Zep 的实验,宣布修正为 58.44%±0.20;
- ▪ Zep 承认算错,但更正后的数字是 75.14%±0.17,反超 Mem0 最佳配置约 10%。
同一张卷子,同一个被试,三周内报了三个分:84、58.44、75.14。每一方都拿得出可复现代码,分歧在提示词、时间戳处理、检索实现这些“配置细节”上。Zep 后来干脆弃考,转头强调 LongMemEval;Mem0 则在 2026 年的自家博客里报出 LoCoMo 91.6 的新成绩。每家的官网首页都写着 SOTA,写的还是不同的卷子。
我的读法很简单:看厂商 A 评测 B 的成绩,永远比看 B 自测的成绩可信——Mem0 论文里给 Zep 的 65.99,和 Zep 自己复测被 Mem0 打回的 58.44,都是对手报的数,反而都比自报的 84 或 94.8 更接近真实战力的可能区间。选型的正确姿势不是抄榜单分,而是拿你自己的对话日志跑一遍两家,看矛盾更新和检索延迟,就像我上面那样。
※ ※ ※
到底怎么选:一台 4GB 机器的账本
把四条路线按“运维成本”排个队,这是我实测完最想说的一节:
场景对号入座:
个人助手、对话为主、要求装完就用——向量便签够用,但必须自己补一刀矛盾处理:召回时把 top-k 全喂给模型并显式要求“注意时间先后”,或者干脆按 created_at 把新记忆加权。Mem0 实测那个 top-1 旧地址问题,一行排序策略就能兜住大半,可惜默认值没做。
数据里有“谁-对-谁-在什么时候”这类关系,且要跨月推理——图谱路线的碎片化事实和双时间戳是真有用,但要接受两个代价:写入延迟一个数量级,和一台至少 8GB 起步的机器。4GB 机器上跑 800MB 常驻的记忆服务,你等于在走钢丝——我知道,因为我今早刚摔过一次。
你要的是一个长期人格而非一个检索器(角色卡、个人 AI、跨项目续命)——Letta 的 MemFS+git 思路是四家里最贴这个需求的,git 跟踪意味着记忆可以 blame、可以回滚、可以 code review,把软件工程最好的发明借给了记忆。
只有一个问题:预算和不许装新软件——老实做分层压缩加摘要,别神化它,也别贬低它。多数“记不住”的场景,其实是提示词里根本没给记忆留位置。
※ ※ ※
尾声
回到开场的崩溃循环。事后复盘:locale 是装系统时 update-locale 写进 postgres 配置的,服务自己管着自己的数据库,启动脚本给了 120 秒超时——三层各自合理,叠在一起就是四十分钟的失明。这几乎是所有自托管记忆系统的隐喻:单看每个组件的文档都无可指摘,故障永远发生在组件的接缝上。
而厂商的基准分数也永远发生在接缝的盲点上:LoCoMo 考“记得”,不考“改得”;论文报平均,用户活在 top-1。你的 AI 记不记得住事,最后取决于你愿不愿意像管数据库一样管它的记忆——备份、超时、locale,一样都少不了。
我的建议:今天先只做一件事——翻出你 agent 最近一次“睁眼说瞎话”的记录,看它是没存、没召回,还是召回了过期版本。三种病,三种药,别一上来就换“记忆系统”。
你的 agent 记忆方案现在跑到哪条路线了?有没有被“召回过期记忆”坑过的同款经历?评论区说一声。
点个在看,转给那个刚给助手装完第三个记忆插件、还没备份过数据库的朋友。
下一篇预告:MCP 发布一周年,号称 AI 工具界的“USB-C 时刻”。一年过去,插口确实统一了,但插上的设备彼此听得懂对方说话吗?我拿一圈真实 server 试给你看。
※ ※ ※
资料来源
- ▪ Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory(arXiv:2504.19413,2025-04)
- ▪ Zep: A Temporal Knowledge Graph Architecture for Agent Memory(arXiv:2501.13956,2025-01)
- ▪ MemGPT: Towards LLMs as Operating Systems(arXiv:2310.08560,2023-10)
- ▪ LoCoMo 基准数据集论文(arXiv:2402.17753,2024-02)
- ▪ Zep 官方博客《Lies, Damn Lies, & Statistics: Is Mem0 Really SOTA in Agent Memory?》及 getzep/zep-papers GitHub issue #5(双方对 LoCoMo 分数的公开对线记录,84% / 58.44% / 75.14% 三版数字均有出处)
- ▪ Letta 官方文档(MemFS、agent dreaming、V1/Agent SDK 对比)
- ▪ Hermes Agent v0.21.3 开源仓库源码:agent/agent_init.py(compaction 默认阈值 0.50)、agent/context_compressor.py(_SUMMARY_RATIO = 0.20)
- ▪ 本文 Mem0 与图谱记忆服务的运行数据均为作者一台 4GB 内存云服务器本机实测(2026-09-17),示例主机、路径与端点均已通用化改写;文中未出现任何真实 IP、密钥或账号信息
评论 (0)
登录 或 注册 后参与讨论。