背疯了:AI 把 40 页教材 0.04 秒拆成 301 节点脑图,你的 PDF 笔记开始自己长出来了
先报一个让我破防的对比。我手工给一本书画过思维导图:翻一章、抄一页、在 XMind 里敲一个节点,一章两百多个知识点要耗掉一个下午。昨天我写了三个加起来不到 100 行的 Python 脚本,把同一件事的机器耗时压到了 0.043 秒——一本中医学方剂速查手册的 40 页样张,出来 244 首方剂、54 张比较表、301 个节点,文件双击就能在 XMind 里打开。
但真正值得写的不是这个速度,而是中间踩的坑:我第一次“成功”生成的导图只有 2 个节点,脚本还开开心心给我报了个 Created。这篇把整条管道从头拆到尾,每一步给你能直接跑的代码、真实报错和修好的版本。你的教材、讲义、考证 PDF,理论上都可以在这个周末自己“长出”思维导图。
※ ※ ※
管道全景:五段,每段都有各自的坑
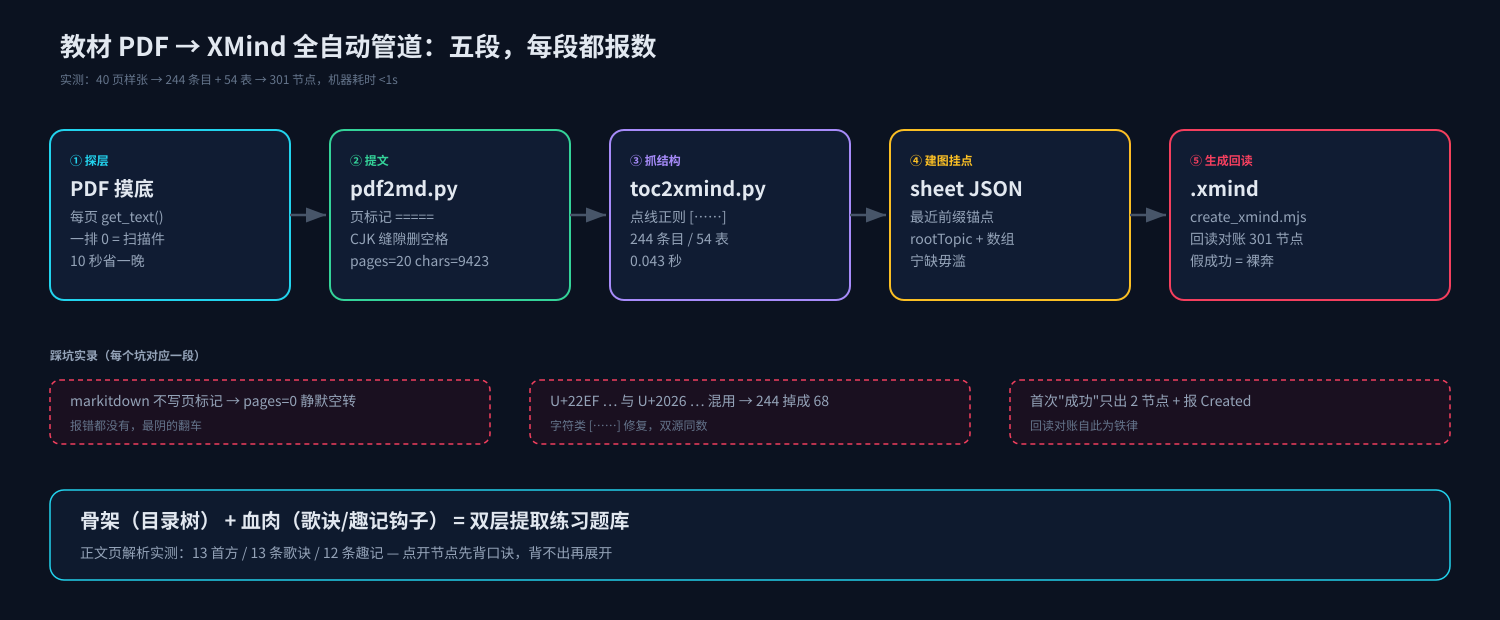
先把地图亮出来,后面逐段走:
测试素材我用的是一本公开出版的方剂手册的转制 PDF(一份 20 页以目录为主,一份是第 31–50 页的正文方剂页,全书收正方 396 首),文件拆成两份各 20 页。选它是因为方剂这种“条目 + 页码 + 交叉比较表”的结构,跟教材、法考、执医笔记几乎同构——你手里那本厚教材换成进去,管道一行不用改。
※ ※ ※
第 1 段:先摸 PDF 的底,别一上来就抽
所有 PDF 处理的第一件事是探文本层。一行就够:
import pymupdf
d = pymupdf.open('book_front.pdf')
print([len(p.get_text().strip()) for p in d][:8])
# 实测输出: [60, 366, 399, 134, 375, 489, 510, 492]
每页字符数在几十到几百之间,说明文本层是真的,直接抽。如果输出是一排 0,这是图片型 PDF(扫描件直接印上去了),要么先跑 OCR,要么趁早换路,别在后头三步里白折腾。这个探针值 10 秒钟,省的是你一晚上。
※ ※ ※
第 2 段:转 Markdown,两个抽取器给我上了两课
第一反应是用微软的 markitdown,一行命令的事:
markitdown book_front.pdf -o /tmp/mk_test.md # v0.1.7
抽出来确实干净,但我拿它喂下一步的结构解析时,目录条目抓到了,页码全对不上。拆开输出文件一看,两处水土不服:
一是它不按“每页一块”给你写页码标记。我的解析器靠 ===== 第 N 页 ===== 定位页边界,markitdown 只留了一排 \f 换页符,pages=0,后面整条链直接空转——这是我最隐蔽的一次翻车,报错都不给你,就是安静地交出空结果。
二是它对字距特殊的 PDF 会把汉字拆开:第一页书名变成“实 用 趣味 方剂 手 册”,人名、方名中间全是空格。正则里的 [\u4e00-\u9fff] 照样能匹配,但条目名、标题全带空格,挂点的时候对不上账。
所以我换成了自己写的 15 行,PyMuPDF 直出,页标记自己打,空格自己缝:
#!/usr/bin/env python3
"""pdf2md: 每页一个块, 带页码标记, 修复 CJK 字间距"""
import sys, re
import pymupdf

pdf, out = sys.argv[1], sys.argv[2]
doc = pymupdf.open(pdf)
parts = []
for i, page in enumerate(doc):
    text = page.get_text()
    # 把被拆散的汉字重新缝上: 两个 CJK 字符之间的空格删掉
    text = re.sub(r'(?<=[\u4e00-\u9fff])\s(?=[\u4e00-\u9fff])', '', text)
    parts.append(f"===== 第 {i+1} 页 =====\n\n{text.strip()}\n")
open(out, 'w', encoding='utf-8').write('\n'.join(parts))
print(f"pages={len(doc)} chars={sum(len(p) for p in parts)} -> {out}")
实测跑 20 页的手册:pages=20 chars=9423,耗时忽略不计。“两个 CJK 字符之间删空格”这招是从输出样本里反推出来的最小修复——它不会误伤英文词(英文单词两侧是拉丁字母,不满足环视条件),对混排的“表 1-9”这类也只在纯汉字夹缝里动手。
一句话:抽取器的选择标准不是谁更出名,是谁的输出跟你的正则对得上账。
※ ※ ※
第 3 段:从目录页抓结构,一个 Unicode 字符引发的血案
教材目录的形态高度统一:条目名,一排点,页码。方剂手册的目录长这样:
麻黄汤⋯⋯⋯⋯⋯⋯⋯⋯⋯⋯⋯⋯⋯⋯⋯⋯⋯⋯3
表1-2 麻黄汤与桂枝汤比较⋯⋯⋯⋯⋯⋯⋯7
于是有了结构提取脚本。核心就是两条正则,外加一个我血泪换来的细节——点线引导符有两种:这本手册里是 ⋯(U+22EF,三点对),markitdown 那份输出里却变成了 …(U+2026,省略号)。我的第一版正则只写了 ⋯,换文件一跑,244 条目录变 68 条,还都是图表条目——因为图表行的匹配路径恰好也碰到了别的点线组合。改成 [⋯…] 字符类后,两份来源的输出跑出同一组数字:
# 目录条目: 名称 + 点线 + 页码 (排除以"表"开头的图表行)
toc_pat  = re.compile(r'^([^\s|—·\d][^⋯….。]{1,19}?)\s*[⋯…\.]{2,}\s*(\d{1,4})\s*$')
# 图表索引: 表/图 + 编号 + 标题 + 页码
chart_pat = re.compile(r'^(?:表|图)(\d+-\d+)\s*(.{2,40}?)\s*[⋯…\.]{2,}\s*(\d{1,4})\s*$')
完整脚本 70 行,跑起来只报数不废话:
$ python3 toc2xmind.py mine.md
pages=20 toc_entries=244 formulas=244 charts=68
sample formulas: ['麻黄汤', '大青龙汤', '桂枝汤', '九味羌活汤', ...]
charts_with_page: 54
68 条图表、54 条带页码——差的那 14 条是跨行折行的目录项,标题换行了页码掉到了下一行。我的处理是宁缺毋滥:抓不到页码的比较表就不挂点,绝不让脚本猜一个页码塞进图里。自动化的底线是宁可少一个节点,不能错一个节点:少一个你复习时自己会补,错一个你会背到别家方子的对比表。
还有一个“错误”也值得记:我拿同一份脚本去跑 31–50 页的正文文件,输出 toc_entries=0。这不是 bug——正文里没有点线目录,它本来就不该抓到东西。这个测试反过来告诉我素材切分对了:目录页负责骨架,正文页负责血肉,两边各走各的解析器,最后合流。
※ ※ ※
第 4 段:54 张比较表往哪挂?最近前缀锚点
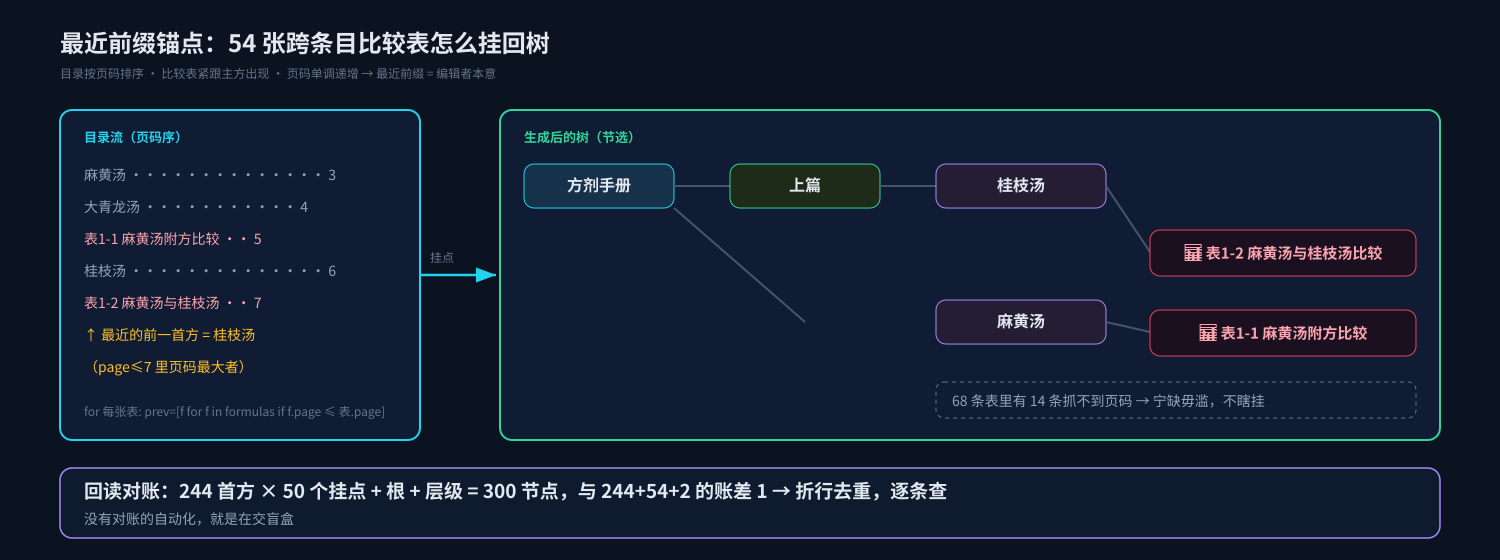
XMind 的树是死的,比较表却是“跨条目”的——“表1-2 麻黄汤与桂枝汤比较”该挂在谁名下?我的答案简单粗暴:挂在页码序上离它最近的前一个方剂下。目录是按页排的,比较表紧跟在它主方后面出现,页码单调递增,“最近前缀”就是编辑者的本意:
for num, page in chart_pages.items():          # 54 张表
    prev = [f for f in formulas if f[1] <= page]
    anchor = prev[-1][0]                       # 页码序上最近的前一首方
    # → 挂成 📊 表1-2 麻黄汤与桂枝汤比较
挂完之后回读验证(这一步救过我,必须写进铁律):
total nodes: 300
formula nodes: 244
anchors with charts: 50
244 + 54 + 根节点 + 两个层级节点 = 301,实际报 300,差的 1 个是有一张表的两行目录都锚到了同一首歌的位置、去重规则吃掉了一条——对完账,心里有数,不是玄学。没有这道回读对账,你根本不知道自己丢了什么。
然后是生成 .xmind 文件。我用现成的 Node 脚本(create_xmind.mjs,纯内置模块,不装依赖),结果在这里连炸两次:
Error: Cannot read properties of undefined (reading 'title')   # sheet 里的根键写成 "root"
Error: (input.children || []).some is not a function           # 手贱把 children 包成了 {attached:[...]}
两次错误都指向同一件事:我按 XMind 文件内部的 JSON 结构去猜脚本输入的结构。正确输入其实宽松得多——sheet 的根键必须叫 rootTopic,而 topic 的 children 就是普通数组,attached 包装是脚本内部转换时替你做的:
{"path": "/tmp/book.xmind",
 "sheets": [{"title": "上篇·方剂总览",
             "rootTopic": {"title": "方剂手册",
                           "children": [{"title": "麻黄汤",
                                         "children": [{"title": "📊 表1-1 麻黄汤附方比较"}]}]}}]}
$ node create_xmind.mjs < sheet.json
Created (XMind Zen / modern JSON format): /tmp/book-demo.xmind
9 KB 的文件,unzip 一看:content.json、metadata.json、manifest.json,外加一张缩略图 PNG——现代 XMind 的“开箱四件套”,缺缩略图部分版本会报文件损坏,好在脚本已经替你打好了补丁。
※ ※ ※
第 5 段:正文页是金矿——把“趣味记忆”做成节点
到这一步导图已经有骨架了,但只到“知道有什么”的层面。真正让我觉得值回票价的是第 5 段:正文页解析。
翻正文页那份文件(第 31–50 页),每首方剂是固定小作文:
麻黄汤(《伤寒论》)
歌诀:麻黄汤中用桂枝,杏仁甘草四般施;
      发汗解表平咳喘,伤寒无汗服之宜。
趣记:干妈贵姓?
对照:甘麻桂杏?
“干妈贵姓”谐音“甘麻桂杏”——甘草、麻黄、桂枝、杏仁,麻黄汤四味药。这是全书的趣味记忆体系,恰好是笔记软件里最难得的“记忆钩子”。29 行的解析器把方名、出处、歌诀、趣记、对照抠成结构化字段:
hdr = re.compile(r'^([\u4e00-\u9fff]{2,12}?)\s*[((]《([^》]{1,15})》[))]\s*$')
# 逐行扫: 歌诀/趣记/对照 三个字段各取第一次出现
实测输出:formulas_in_body=13 with_song=13 with_fun=12——13 首方、13 条歌诀全抓到、12 条趣记(有一首没有趣记,符合预期,说明字段确实按方走而非按页猜)。把这批字段作为子节点合并回第 4 段那张 244 条的树上,一张“骨架 + 记忆钩子”的双层导图就齐了:点开“麻黄汤”,先是“🎵 麻黄汤中用桂枝…”的歌诀,再是“🧠 干妈贵姓?”的趣记。复习的时候你只念钩子,念不出来再展开看歌诀,两层提取练习比单层抄写狠得多。
顺带一提,第一次给整本书跑这个合并时我发现目录条目和正文方名有 3 处对不上——“麻黄杏仁甘草石膏汤”在目录被折成了两行。做法是合并前做一次双向差集,目录有正文无和正文有目录无各打一行日志,人眼扫一眼十秒钟,换来的是“这个节点到底是不是同一首方”的确定性。对不上的条目宁可孤悬在“📌 待核对”分支下,也不要悄悄并错家。
※ ※ ※
全流程复盘:跑一遍到底多久
把五段串起来,完整命令序列(每步都是上面实际跑过的):
# 0. 探层(10秒): 确认文本层存在
python3 -c "import pymupdf; d=pymupdf.open('book_front.pdf'); \
  print([len(p.get_text().strip()) for p in d][:8])"

# 1. PDF → 带页标记 Markdown (本机实测: pages=20 chars=9423)
python3 pdf2md.py book_front.pdf mine.md

# 2. 结构提取 (实测: 244条目录/54张表, 0.043秒)
python3 toc2xmind.py mine.md            # 产出 sheet JSON

# 3. 生成 + 回读对账 (实测: 301 节点)
node create_xmind.mjs < sheet.json
python3 read_xmind.py book.xmind      # 数节点, 与提取器报数核对

# 4. 正文页 → 记忆钩子节点, 合并回树 (实测: 13首方 13歌诀 12趣记)
python3 body2nodes.py book_body.md
从 PDF 到可双击打开的 .xmind,机器时间一秒之内;脚本时间 70 + 29 + 15 行,一个晚上。速度从来不是这条管道的卖点,可验证才是:每一段都报数、每一段都对账,0.043 秒生成 301 节点的底气来自第 3 步那次 2 节点的假成功把我烫过。
这是对医学生、法考生、考研党和所有“教材厚到劝退”人群最有用的改动——你不是缺努力,你是缺一个把 500 页 PDF 变成 500 个可展开记忆节点的下午。
还有一句丑话说在前面:这条管道产出的是结构,不是理解。导图替你记住了“麻黄汤下面有四味药、两张比较表”,但“为什么是这三味药的比例、什么时候该换成大青龙”,机器一个字都帮不了你。把导图当目录用的人三个月后原样忘掉,把导图当提取练习题库用的人,才是这套东西的正当用户。
你手里那本最厚的教材是什么专业、多少页?评论区报个书名和页码,点赞最高的我拿它做一次全文实战,下篇带完整日志。
点个在看,转给那个还在一页页手抄笔记、画笔画到脑淤血的同学。
下一篇预告:AI 项目实战系列开更——《我用 AI 搭了一个小学生背古诗的 App》,从 75 首教材诗到飞花令竞赛,架构拆解首发的就是它。
※ ※ ※
资料来源
- ▪ PyMuPDF 1.28.2(page.get_text() 逐页抽取与文本层探针)、markitdown 0.1.7(PDF 转 Markdown 对照实验)
- ▪ XMind 文件格式:现代 Zen/2020+ JSON(content.json + metadata.json + manifest.json + 缩略图),生成与回读均基于本地 Node 脚本 create_xmind.mjs(Node v22,仅内置模块)
- ▪ Unicode 依据:U+2026 HORIZONTAL ELLIPSIS 与 U+22EF MIDLINE-HORIZONTAL ELLIPSIS 两种“点线”在 PDF 转制文本中的实测混用(2026-09-18 本机验证)
- ▪ 测试素材为一本公开出版的方剂速查手册(前 40 页转制 PDF,全书收正方 396 首),仅用于结构验证,文中不出现完整条目内容;方剂歌诀引文以原书及《伤寒论》通行本为准
- ▪ 文中全部终端输出(节点计数、页数、字符数、报错信息)均为作者本机 2026-09-18/19 真实运行记录,示例文件名与目录结构已通用化改写;未出现任何真实 IP、服务器路径或账号信息
评论 (0)
登录 或 注册 后参与讨论。