AI 摊牌了:你的助手学会了点鼠标,但 108 个真实任务只做完 20.6%
2026 年 9 月 · Computer-Use 产品版图深度解读 · 全文约 4600 字 · 阅读时间 11 分钟
上个月帮朋友看一台服务器,我人在高铁上,手头只有手机。要是放在两年前,这活儿今天就废了——得等回到酒店开笔记本。现在我对着手机说了句“上去看看磁盘哪块目录吃的,日志给我拉最近的”,屏幕那头一台云主机上的 agent 自己开了终端、敲了命令、把结论回给我。全程我没碰键盘。
这种事现在有个统一的名字:computer use,让 AI 直接操作电脑。截图进去,鼠标点击和键盘敲击出来:AI 像人一样用软件,而不是靠接口。
听起来很顺,但这个赛道过去一年死掉的产品比活下来的多:OpenAI 的 Operator 上线八个月关停,独立浏览器 Atlas 从发布到停止服务不到十个月。与此同时,字节跳动的开源模型 UI-TARS 在一个 7B 参数的小模型上,把桌面自动化基准打到了商业产品前面。
死的都是“做一个新入口”的产品,活下来的都是“钻进现有工作流”的。这是整张版图过去一年最重要的一条分界线,下面展开讲。
※ ※ ※
一条公认的时间线:从 14.9% 到刷爆基准线
先把硬事实钉住,后面所有判断都建立在这条线上。
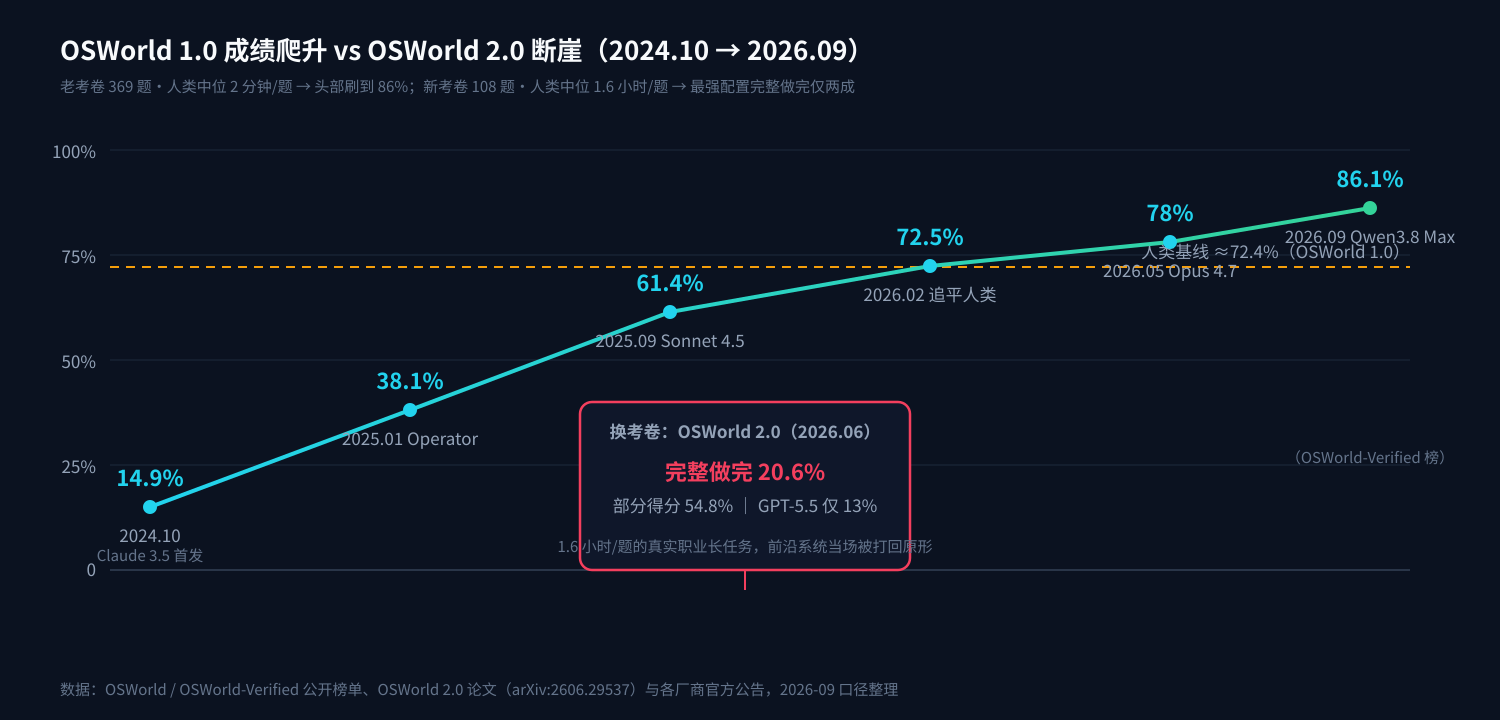
2024 年 10 月,Anthropic 随 Claude 3.5 Sonnet 发布 computer use 公测:模型看一张截图,输出鼠标键盘动作。官方自己报的 OSWorld 成绩是 14.9%(单截图模式,多步模式 22%)。同一年人类的基线成绩约 72.4%。当时 AI 连人工作量的七分之一都摸不到。
2025 年 1 月,OpenAI 发布 Operator(底层模型叫 CUA,Computer-Using Agent),OSWorld 拿到 38.1%,是当时新的天花板,订阅价格 200 美元/月。
之后是肉眼可见的爬升:Claude Sonnet 4.5 在 OSWorld-Verified 上到 61.4%(2025 年 9 月),Sonnet 4.6 到 72.5% 追平人类(2026 年 2 月),同年 5 月 Opus 4.7 到 78%。注意这条曲线的形状:它不是一次次换代跳上去的,而是同一个 API 原语(截图进、动作出)配上逐季变强的视觉模型,交互协议一行没改,分数自己涨上来。模型升级白送能力,是这个赛道和其他所有应用层生意最不一样的地方,也是创业公司挤破头要往底层贴的原因。到今年 9 月 4 日更新的 OSWorld-Verified 公开榜单,阿里 Qwen3.8 Max 以 86.1% 居首,Claude 的两个旗舰型号并列 85% 紧随其后。
19 个月,从 15% 到 78%——这是整个 agent 领域最可信的一条“真的在进步”的曲线。
然后,曲线把自己跑死了。OSWorld 1.0 一共 369 个任务,人类中位耗时约 2 分钟。当头部系统在短任务上集体摸到 80%+,这个考卷就失去了区分度。多出来的分数,是脚手架调优还是判分器抽风,谁也说不清。
这就是今年 6 月 28 日 OSWorld 2.0 出现的原因,也是理解当前版图最好的一把钥匙。
港大 XLANG Lab 牵头、Snorkel 资助的这份新基准,把题量砍到 108 道,但每道都是真实职业工作流:横跨 31 个自托管 Web 环境和桌面应用,覆盖调研、工程、财务、合规、文档生产。人类完成一道题的中位耗时从 2 分钟变成 1.6 小时,69.6% 的题人类自己要做一个小时以上。判分从通过/不通过,改成 27 个左右的部分得分检查点。
新考卷发下来的成绩是这样的:写论文时最强的配置(Claude Opus 4.8 开最大思考量加批量工具调用、预算放到 500 步)完整做完的题只有 20.6%,部分得分 54.8%。GPT-5.5 二值完成率约 13%。之后分数在爬:Opus 5 发布时 Anthropic 自报 OSWorld 2.0 达 70.57%(第三方追踪榜 Snorkel 口径二值完成率 31.43%),OSWorld 团队 9 月初的读书会上透露,发布不到一天的 Claude Fable 5.1 把部分得分推过 60%、完整做完推过 45%。
一句话:老考卷接近满分,新考卷刚过半。“AI 能用电脑了”这句话,2026 年的正确读法是“能用,但离职业水准还差着一整个基准版本号”。
论文作者归纳的失败模式也值得抄下来:现在的 agent 不是不会点按钮,而是:跟丢约束条件、漏掉任务中途才出现的信息、该问用户的时候自己猜、做完不验证。四种病全是“长任务管理”的病,不是“视觉操作”的病。
※ ※ ※
产品版图:2026 年 9 月,谁活着、在哪跑、怎么收费
把散在各家的信息拼成一张表(信息截至 2026 年 9 月中旬,各家迭代极快,选型前务必核对官网):
三点观察,比表本身重要。
第一,独立入口全灭,嵌入工作流全活。OpenAI 是最极端的教学案例:Operator 独立站开了八个月关掉并入 ChatGPT agent;Atlas 浏览器 2025 年 10 月高调发布、2026 年 7 月 9 日宣布日落、8 月 9 日停止服务,前后活了三十三周,官方迁移公告写得干脆:书签不会自动转移,请自己在死线前导出。同一天 OpenAI 发布 ChatGPT Work 和 GPT-5.6,把浏览能力拆进桌面超级应用。十八个月两次掉头,产品名换了四五个,这条赛道的洗牌烈度可见一斑。
第二,“agent 的操作系统”正在长出来,而且不在模型层。今年 3 月底,Chrome 146 的 Canary 版里出现了一个叫 navigator.modelContext 的实验接口,配套协议叫 WebMCP:网站可以用 JavaScript 声明“本页面提供哪些工具、agent 可以怎么调用”。翻译成人话:过去 agent 看网页靠猜像素,以后网页可以直接把操作菜单递到 agent 手里。浏览器从“agent 要模仿人类去操作的对象”,变成“给 agent 提供原生 API 的平台”。这是今年最值得盯的信号,比任何一个模型的分数都值钱。
第三,开源模型在 GUI 专精任务上咬住了商业旗舰。视觉定位基准 ScreenSpot-Pro 上,UI-TARS-1.5 拿 61.6%,同期 Operator 只有 23.4%;AndroidWorld 手机自动化 64.2%,Operator 干脆不支持移动端;桌面端 OSWorld 42.5% 对 38.1%——一个开源 7B 小模型压过了 200 美元/月的商业产品。有个反直觉的细节:72B 的 UI-TARS 在 OSWorld 上(24.6%)反而不如 7B 的(42.5%),GUI 专精任务不是越大越好,训练配方比参数规模关键。
※ ※ ※
三条技术路线:看像素、看结构树、还是混合
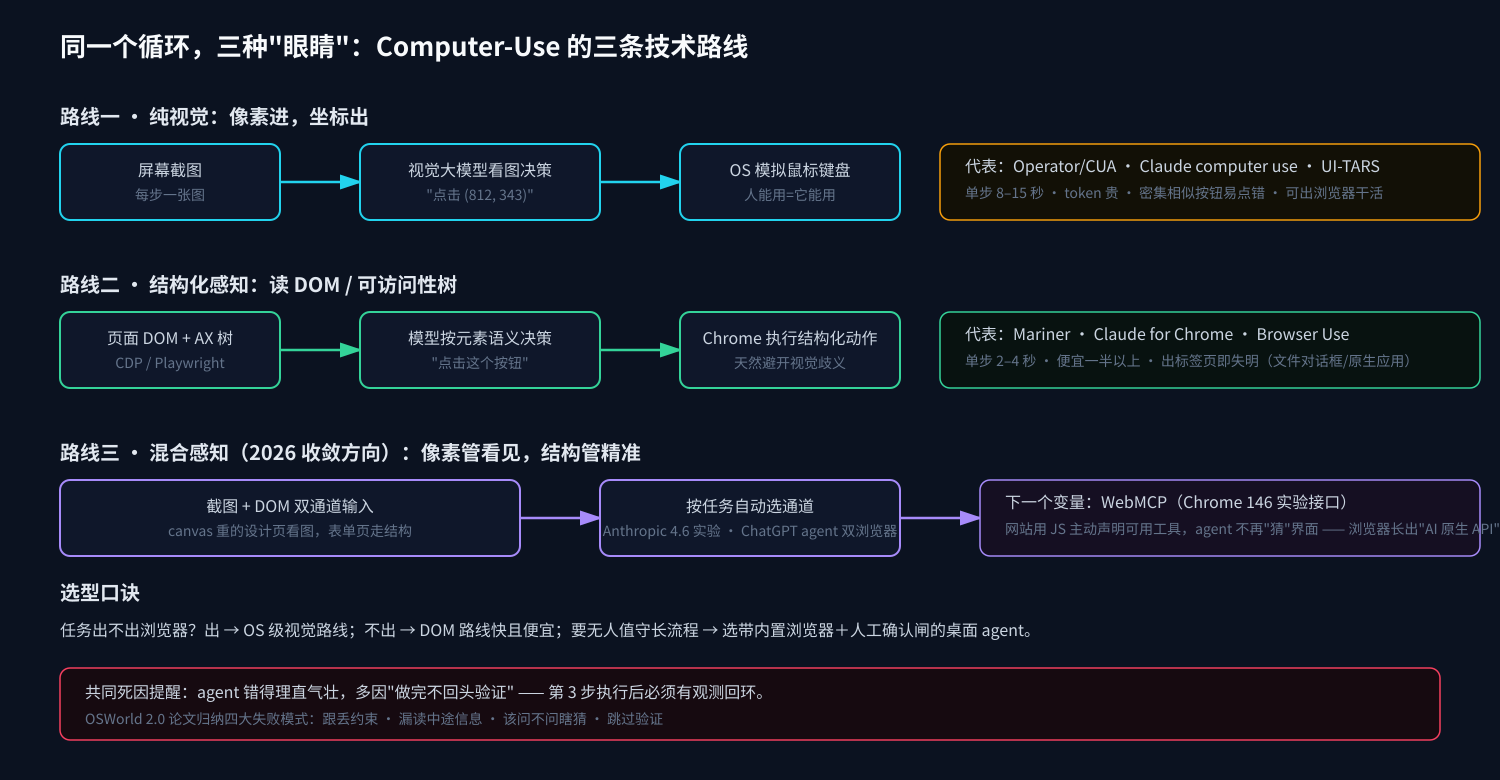
所有 computer-use 产品拆开都是同一个循环:截图 → 视觉模型解析界面 → 语言模型决策下一步 → 执行鼠标键盘动作 → 再截图检查。区别只在“看”和“动”的方式上。当前三条路线并存:
路线一:纯视觉(像素进,坐标出)。Operator/CUA 和 Claude computer use 都是这个路子:每步看一张截图,输出“点击 (812, 343)”。好处是所见即所得。人有眼睛就能用的软件,它有截图就能用,没有 API 的祖传 ERP、扫描件打印对话框统统不挑。代价是每一步都要“看图说话”,单步延迟 8–15 秒,token 烧得飞起;碰到五个长得一样的“查看”按钮就容易点错。
路线二:结构化感知(DOM / 可访问性树)。Mariner 和大多数浏览器扩展派的做法:不截图,直接读页面的 DOM 和 accessibility tree,输出“点击这个元素”而不是“点这个坐标”。单步延迟压到 2–4 秒,快好几倍,天然避开视觉歧义。代价是出了浏览器就是瞎子:本地文件对话框、原生应用、任何不在标签页里的东西,一概摸不到。
路线三:混合感知。趋势已经很明显:Anthropic 4.6 的发布说明里提到内部在把截图和 DOM 表示合并;ChatGPT agent 同时挂视觉浏览器和文本浏览器两套工具;UI-TARS 用视觉模型但配合可访问性信息兜底。像素管“看见一切”,结构管“看得精准”,两边互补。
选型口诀:任务出不出浏览器?出,选 OS 级视觉路线;不出,选 DOM 路线快且便宜;要无人值守跑长流程,选带内置浏览器的桌面 agent,把登录态和动作审计关在自己的权限模型里。
下面这个循环用代码表示最直观,任何一家的实现都长这样:
def agent_loop(goal, env, max_steps=100):
    history = []
    for step in range(max_steps):
        obs = env.screenshot()                 # 1. 看:抓当前屏幕
        action = policy(goal, history, obs)    # 2. 想:模型决定下一步
        if action.type == "done":
            return verify(env)                 # 3. 检查:别信模型说完成就完成
        env.execute(action)                    # 4. 动:模拟点击/键入
        history.append((obs, action))
    return timeout_report(history)
四个环节,今天各家拉开差距的全在第 2 步的模型质量和第 3 步有没有认真做。OSWorld 2.0 论文点名“跳过验证”是四大死因之一:自己做完不回头检查的 agent,错得理直气壮。
※ ※ ※
你的哪类活儿现在真的能交出去
把“能不能用”翻译成具体场景,按当前成熟度排三档。
第一档:只读不写、结果可人工核,已经能规模化用。价格比对、多站点信息收集、批量读 PDF 回填表格、给没有 API 的内部老系统当“人肉适配器”抓数。这类任务共同的特征是做错了也不爆炸,且你天然会顺手检查结果。WebVoyager 这类真实网站导航基准上,头部产品成功率在 87%–94% 区间,表单填写和信息收集早就过了可用线。
第二档:有写操作、有确认环节,试点可以但别撒手。报销单提交、CRM 更新、后台配置变更。Claude Cowork 和 ChatGPT Work 都在这个档位下重注:不可逆动作前弹人工确认,操作全程可回放。业内普遍的做法是“agent 干九成的体力活,人点最后一下确认”。Anthropic 官方自己都建议 computer use 跑在最小权限的虚拟机或容器里,这个态度比任何营销词都诚实。这里有个容易被忽略的成本账:一个 30 步的桌面任务,视觉路线要 4 到 8 分钟墙钟时间,比人手动做慢一倍,但它发生在你睡觉的时候。这个品类今天卖的不是“更快”,是“不用你在场”。想清楚这一点,就知道哪些活儿值得交、哪些纯属表演。
第三档:跨多系统长流程、涉及支付、依赖隐藏状态,别交。OSWorld 2.0 的数据就钉在墙上:中位时长 1.6 小时的真实工作流,最强配置完整做完率两成上下。论文里最扎心的一条是“该问用户的时候猜”——长任务里 agent 遇到歧义倾向于自己脑补而不是停下来问,脑补错了继续往下走,等你发现时它已经把错误状态传到了第三个系统。
还有一个更工程化的判断标准:数你的任务有多少步。20 步以内、每步结果肉眼可验的活儿,现在的 agent 能接;上百步、错误要到第 80 步才暴露的活儿(OSWorld 2.0 平均每题 318 次工具调用),交给 AI 等于给自己埋一场要人工复盘的长故障。差的就是这一步:演示视频和生产系统之间,隔的不是模型智商,是验证回路。
一个实用的信任建立路径,是评测者社区总结出来的:从整理下载文件夹这种删了也不心疼的任务开始 → 授予只读权限跑收集类任务 → 再逐步给写权限,每次扩权都对应你检查过它的上一阶段记录。把 agent 当新来的实习生管,进度会比你想的快,但永远别给它你的银行卡密码。
※ ※ ※
房间里的大象:你的 agent 会替你被骗
让 AI 操作电脑,等于把一双手交给一个会看网页的模型,而网页上有人专门投毒。这叫间接提示注入:攻击者把指令藏在正常内容里,agent 读到就当真执行。它和“你的助手正在替你读垃圾网页”是同一个问题的两面。
这个赛道目前最认真的公开防线也在 Anthropic:Gray Swan 注入基准上,Opus 5 被测 15 次之内攻击成功率收敛到 2.6%,浏览器环境里开启自动防护后 129 个测试环境全部归零。这是全行业唯一持续公开数字的厂商,其他家的态度基本是“建议虚拟机隔离”。防注入的透明度应该进你的选型清单,权重不低于跑分。
※ ※ ※
接下来十二个月,建议盯四件事
- WebMCP 的正式落地。Chrome 实验接口转正、Google 在 I/O 或 Cloud Next 官宣支持的那天,浏览器 agent 的感知成本会下一个台阶。网站主从那天起要多一门“给 AI 看”的功课,就像当年做 SEO 一样。
- OSWorld 2.0 分数过 50% 完整做完率。现在最快追分的产品还没到这条线(Fable 5.1 的 45%+ 已非常接近)。一旦过去,“无人值守跑一天”从宣传语变成可验收的工程指标,第二档场景整体向第一档迁移。
- 判分器的战争。UC Berkeley 今年 4 月已经演示过基准可以被刷分;同一系统在 OSWorld 2.0 上“部分得分 68% 还是完整做完 31%”是两个都合法规的叙事。看数字先问版本号和口径,这个习惯能过滤掉八成的发布会通稿。
- 开源阵营的移动端缺口。UI-TARS 在 AndroidWorld 的 64.2% 至今没有商业对手正面应战(Operator 不支持移动端),手机操作自动化会是下一个卷点,也是离普通人最近的入口。
写在最后。两年前“AI 会用电脑”是演示视频里的科幻,今天它是榜单上的百分比、关停公告里的书签导出提醒、和一份 20.6% 的成绩单。方向没人怀疑,速度普遍高估,终点普遍提前。把“只读类”活儿交出去,是你现在就能做的最划算的事。
你现在把哪类活儿交给了会点鼠标的 AI?又在哪一步被它坑过?评论区说一个具体场景,点赞最高的那种活儿,下篇我拿真机跑一遍全过程。觉得有用,点个“在看”转给那个还在手动填表的朋友。
下一篇预告:AI 视频生成实战,从分镜脚本到 720p 成片的完整工作流。
※ ※ ※
资料来源
- ▪ OSWorld 2.0 论文,arXiv:2606.29537(2026-06-28 提交),XLANG Lab / 港大,Snorkel AI 资助;OSWorld-Verified 公开榜单 2026-09-04 更新
- ▪ Anthropic 官方:Claude Cowork 产品页、Claude in Chrome GA 公告(2026-08-28)、Cowork 内置浏览器公告(2026-08-26)
- ▪ OpenAI 帮助中心:《Evolving Atlas into ChatGPT for browser-based agentic work》(Atlas 2026-08-09 停服);The Verge 相关报道
- ▪ ByteDance UI-TARS / UI-TARS-Desktop 开源仓库(Apache 2.0)与官方评测口径;MobileRL 论文(arXiv:2509.18119)交叉印证 AndroidWorld 数据
- ▪ Browser Use、Stagehand 项目主页;OpenClaw 仓库与第三方统计(星标/周下载,2026-08)
- ▪ 第三方横评:Contra Collective(2026-07,OSWorld/WebArena/自建采购流三列对照)、The GreyLens(2026-09 版图)、Simular 选型指南
- ▪ 本文撰写于 2026-09-20;文中产品状态与基准成绩均为公开报道口径,选型前请以官网当日信息为准。文中未使用任何作者真实服务器的运行数据;涉及的主机与端口示例均为说明性质。
评论 (0)
登录 或 注册 后参与讨论。