AI 杀疯了:你的第一条 AI 短片只有 5 秒一格,得像积木一样拼出来
2026 年 9 月 · AI 视频生成实战 · 全文约 4700 字 · 阅读时间 12 分钟
上周刷到一条“AI 生成的宣传片”,弹幕全在喊“取代摄影师”。我点开原片信息看了一眼:分辨率 704×1280,时长 5 秒,右下角压着一枚去不掉的平台水印。
这就是今天 AI 视频的真实水位:铺天盖地的“成片”,单次生成大多只有 5 到 10 秒。模型很能画,但不会连着讲故事。把它们拼成一条完整短片,中间全是坑——首尾帧对不上、角色换个镜头换张脸、排队排到你怀疑任务丢了。
这篇讲一条完整的工作流:从一段脚本,到一条 1080p 短片。所有时间数字来自我今早的一次真实跑通,代码可直接复制运行。
※ ※ ※
📋 先给你全流程的“账本”
一句话:视频模型的短板用图片模型补,图片模型的死穴(不会动)用视频模型补——工作流的本质是两个短板拼一个长板。
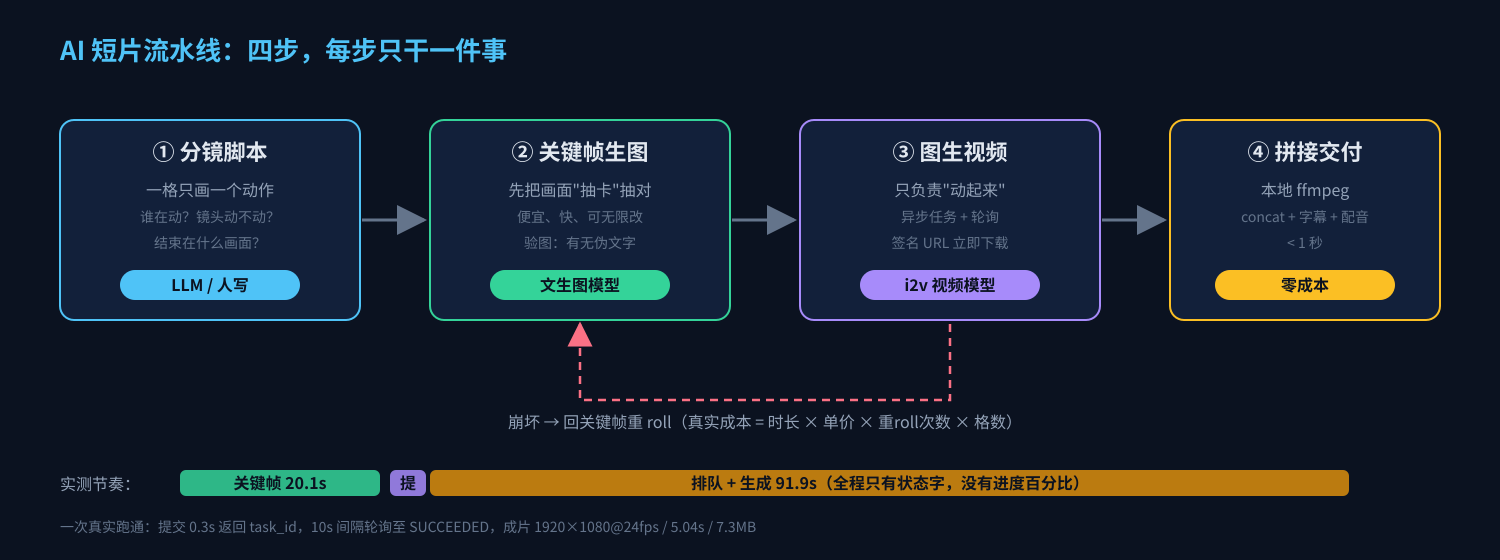
图1:四步流水线与一次真实跑通的时间节奏
先声明口径:文中示例主机、密钥全部用占位符和文档保留地址(203.0.113.x)表示,与任何真实环境无关;API 形态以各厂商公开文档为准。
※ ※ ※
🎬 第一步:为什么必须先写分镜,不能直接“一句话出片”
先看 2026 年 9 月各家公开口径的单次生成上限:
注意一个时间点:Sora 的独立 API 定在 2026 年 9 月 24 日关闭,官方帮助中心已经发了迁移公告。也就是说,如果你的管道里写死了某一家,这两周就该把“可替换”做掉——这是工作流设计问题,不是模型好坏问题。
就算上限给到 15 秒,模型也只在单一连续镜头内兑现它。你在一条 prompt 里写“主角推门进屋,坐下,打开电脑,屏幕亮起特写”,它大概率只演到推门就结束,或者四个动作糊成一锅粥。扩散模型逐帧去噪,时序一致性是它最弱的科目:镜头越复杂,崩坏概率越高。
所以专业做法和视频剪辑一样——一个镜头只干一件事。写分镜脚本时问自己三个问题:这一格画面里谁在动?镜头动不动(推拉摇移还是固定)?这格结束在什么画面上?第三个问题最重要,它的答案就是你后面要生成的关键帧。
我拿一个 15 秒的样片做例子,三段分镜:
S1  海面晨雾,帆船静止远景          (建立镜头,5s)
S2  船身随浪起伏,镜头缓慢推近      (主体动作,5s)
S3  船头破开水面,阳光刺出云层      (情绪收束,5s)
※ ※ ※
🖼️ 第二步:关键帧先行——这是整条管道最值钱的一招
新手最容易犯的错:直接把文字丢给文生视频模型。效果差,还死得慢——一次 t2v 要等一两分钟,跑出来的画面跟你脑内的完全不是一回事,改 prompt 再赌一次,额度烧光了片没出来。
老手的顺序反过来:先用文生图模型把画面“抽卡”抽对,再让视频模型只负责“动起来”。 图便宜、快、可以无限改;视频贵、慢、只能整体重roll。把可控性强的环节留在前面,把不可控的环节压缩到最小,这就是工作流的核心逻辑。
文生图这一步还有个隐藏价值:关键帧就是你的镜头锚点。同一场景换个动作,复用同一张底图;上一条视频的首帧,就是下一条的参考图。一致性不是玄学,是资产复用。
今早我用一个开源系的图生视频组合实测。提交关键帧生成的请求长这样(模型名和端点按你手上的服务替换):
curl -s "$BASE_URL/api/v1/services/aigc/multimodal-generation/generation" \
  -H "Content-Type: application/json" \
  -H "x-api-key: $API_KEY" \
  -d '{
    "model": "wan2.7-image",
    "input": { "messages": [{ "role": "user", "content": [
      { "text": "Cinematic wide shot, a small wooden sailboat on a calm open sea at dawn, pink and gold clouds, low sun, gentle swells, film still, 16:9, ABSOLUTELY NO TEXT" }
    ]}]},
    "parameters": { "size": "1280*720", "n": 1 }
  }'
20.1 秒后拿到一张 1280×720 的图。实测中两个细节值一千字:
一、提示词里必须写“反文字”咒语。 画面模型有印伪文字的幻觉,风景片里会自己长出“杂志名”。“NO TEXT” 压不干净时要补一句狠的:the image must contain ZERO glyphs of any kind, any visible character is a defect。生成完必须验图再进下一环节——我把图丢给了一个视觉模型,问题就一句话:“图中有没有任何文字、字母或 logo?有则写出内容。”有字就重roll,每张最多 3 次。
二、返回的 URL 是带签名的临时链接,会过期。 拿到立即下载成文件,别把 URL 存进数据库打算“以后再用”——第二天它就 403 给你看。
※ ※ ※
🚀 第三步:图生视频——提交、轮询、取件,一个 60 行的管道
“动起来”这一步,行业统一的接口形态是异步任务:提交后拿一个 task_id,排队,你轮询状态,成功后给回一条同样会过期的视频 URL。没有任何一家会同步返回视频——生成一段 5 秒视频要几十秒到几分钟,同步 HTTP 早就超时断了。
所以工程重点不在提交(0.3 秒就返回),在轮询和取件的健壮性。提交请求:
# 首帧转 base64 塞进 media 数组,声明为异步任务
B64=$(base64 -w0 keyframe.jpg)

curl -s "$BASE_URL/api/v1/services/aigc/video-generation/video-synthesis" \
  -H "Content-Type: application/json" \
  -H "x-api-key: $API_KEY" \
  -H "Authorization: Bearer $API_KEY" \
  -H "X-DashScope-Async: enable" \
  -d '{
    "model": "happyhorse-1.1-i2v",
    "input": {
      "prompt": "The camera slowly pushes in toward the sailboat. Gentle swells rock the boat. Clouds drift across the dawn sky. Calm cinematic motion.",
      "media": [{"type": "first_frame", "url": "data:image/jpeg;base64,'"$B64"'"}]
    },
    "parameters": { "size": "1280*720", "duration": 5, "watermark": false }
  }'
# → {"output": {"task_id": "ee8d...", "task_status": "PENDING"}}
注意 media 数组里 type: first_frame 这个写法:首帧不是顶层字段,必须嵌在数组里带类型声明。我见过不少教程直接写 img_url 顶层字段,那是旧版接口,新版会 400。
轮询侧的完整 Python(复制即用,把端点和密钥换成你的服务):
import json, sys, time, urllib.request, os

BASE, KEY = os.environ["BASE_URL"], os.environ["API_KEY"]
HDRS = {"x-api-key": KEY, "Authorization": f"Bearer {KEY}"}

def poll_until_done(task_id, timeout_s=900, interval=10):
    t0 = time.time()
    while time.time() - t0 < timeout_s:
        req = urllib.request.Request(f"{BASE}/api/v1/tasks/{task_id}", headers=HDRS)
        out = json.loads(urllib.request.urlopen(req).read())["output"]
        status, elapsed = out["task_status"], time.time() - t0
        print(f"  {elapsed:6.1f}s {status}", flush=True)
        if status == "SUCCEEDED":
            return out["video_url"]
        if status in ("FAILED", "ERROR", "CANCELED"):
            raise RuntimeError(f"生成失败: {json.dumps(out)[:300]}")
        time.sleep(interval)
    raise TimeoutError(task_id)

url = poll_until_done(sys.argv[1])          # 传入提交响应里的 task_id
os.system(f'curl -s -o clip.mp4 "{url}"')   # 立即下载!URL 会过期
今早的实测时间轴,原样贴(task_id 截断):
KEYFRAME_OK   t=20.1s     ← 文生图
SUBMIT_OK     t=0.3s      ← 提交视频任务
poll  0.6s RUNNING
poll 10.7s RUNNING
 ...每 10 秒一格,全程没有报错,也没有进度百分比...
poll 91.9s SUCCEEDED     ← 视频就绪
DONE  total=112.0s size=7.3MB
ffprobe 验成片:1920×1080, 24fps, 5.04s。请求的是 1280*720,落地是 1080p——分辨率参数会被映射到最近的预设档,请求 720 给 1080 是好事,但也意味着别假设“请求什么就得什么”,以实际返回为准,验收脚本里要读真实的 width/height。
三个我踩过的坑,都值一条规则:
- watermark 默认可能是开的,必须显式传 “watermark”: false。另一家平行的视频 API 干脆没给关闭参数,水印焊死在右下角——选型时要试的不是“能不能生成”,是“能不能干净地生成”。
- 轮询别裸奔。有的服务限流 1-2 次请求/分钟,1 秒一poll直接 429,你的脚本会把“被限流”误判成“任务失败”,把队列里正常的任务又提交一遍——重复扣额度。10 秒一格起步,失败重试前先退避。
- RUNNING 不等于快好了。92 秒里没有任何进度信息,只有状态字。体验层要做“已排队 X 秒”的文案而不是假进度条,因为真进度拿不到。
※ ※ ※
🔗 第四步:拼接——一致性才是 AI 短片的生死线
三段 5 秒拼 15 秒,技术上是最简单的一步:
# 前提:三段同模型、同参数生成,编码参数一致才能 -c copy 直拷
printf "file 'clip1.mp4'\nfile 'clip2.mp4'\nfile 'clip3.mp4'\n" > list.txt
ffmpeg -f concat -safe 0 -i list.txt -c copy final_15s.mp4
两个 ffmpeg 的坑先替你埋好:文件列表必须是真实文件,进程替换 <(...) 会报 “Impossible to open /dev/fd/...”;编码参数不一致时 -c copy 会花屏或掐段,退路是重编码 -c:v libx264,慢但稳。
真正的难点不在工具,在接缝:clip1 结束时帆船在画面左侧、夕阳在右,clip2 如果重新生成关键帧,船可能瞬移到右边——观众一眼出戏。行业里三招:
第一招:首尾帧锚定。 可灵 3.0 等新模型支持“最后一帧参考图”:把 clip1 的尾帧截图丢给 clip2 当首帧,镜头就接上了。支持这功能的,用它的图生视频接口;不支持的,退而求其次,把尾帧塞进 i2i 模型(图生图)做轻度演化,再喂给视频模型。
第二招:一致性靠参考图资产,不靠提示词。 角色、场景、道具先各生成一张“设定图”,每个镜头的关键帧生成都把它当参考喂进去。提示词只能描述“大概长什么样”,参考图才能锁定“就是这张脸”。
第三招:运动提示词只写“怎么动”,不重描画面。 画面已经被首帧锁死了,视频提示词里再写一遍“粉色天空金色云”是浪费 token 还制造矛盾。只写三样:主体的动作、镜头的运动(slowly pushes in 这类运镜短语)、氛围(calm / energetic)。英文目前仍比中文稳。
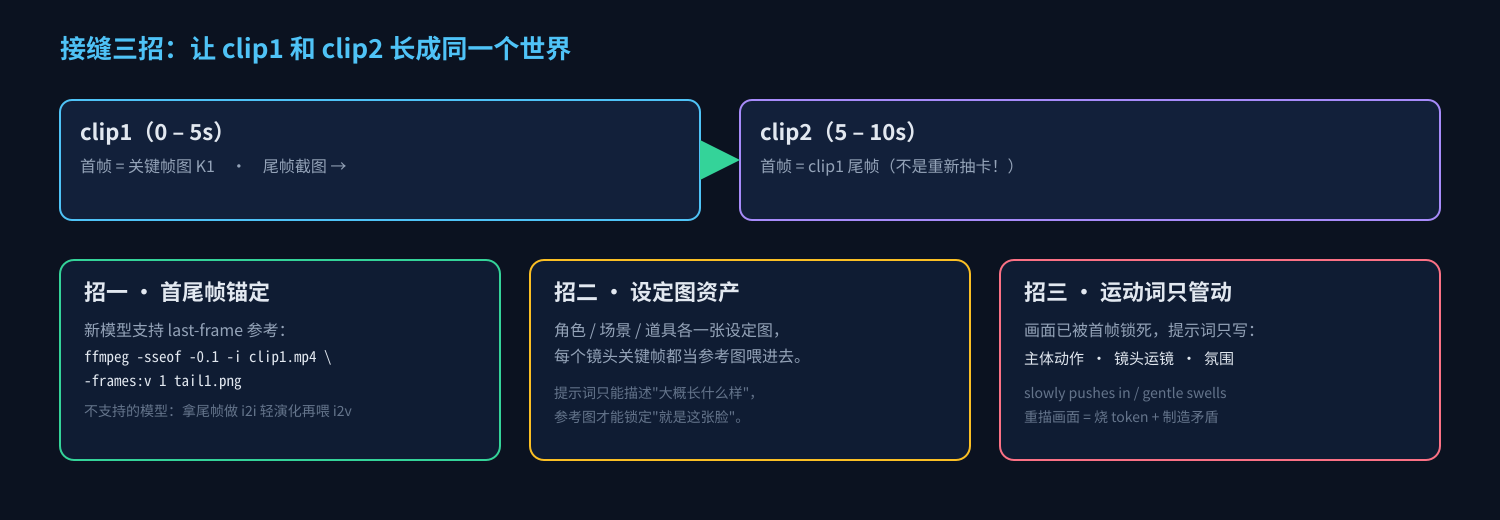
图2:让两个镜头长成同一个世界的三招
字幕、配音、BGM 是最后一层的本地活:SRT 字幕用 subtitles=xx.srt:force_style='FontName=Noto Sans CJK SC,MarginV=40' 一次成功,别用 drawtext(表达式里的空格会被 shell 吞掉,报一句你完全看不懂的错);TTS 配音按每段台词的秒数对齐到镜头上——这跟传统后期是一个逻辑,AI 没有消灭这一步,只是把前面的拍摄成本打到了零。
※ ※ ※
💰 第五步:算账——什么时候值得为 AI 视频付钱
公开报道口径的价签:Veo 3.1 Lite 约 $0.05/秒(720p),可灵 3.0 约 ¥0.8-1/秒(音频内含),第三方 API 聚合平台上可灵约 $0.029/秒。一条 15 秒 1080p 短片,模型侧成本大约 1-3 美元。
但实际成本要乘一个重roll系数:AI 视频的一次成功率没有你想的高。手部畸变、物体穿模、文字乱码,任何一格都可能重抽 2-4 次。算账公式:真实成本 ≈ 时长 × 单价 × 平均重roll次数 × 分镜格数。5 秒一格、平均 roll 2.5 次的 15 秒片子,模型费就是十几美元——是“能不能用”和“用的起不起”的分水岭。
所以我的分层建议:
一个值得盯的时间点:某头部模型的独立 API 9 月 24 日关闭。这种事还会反复发生——模型格局没定,你的管道结构应该比任何一次选型正确更重要。
※ ※ ※
写在最后
112 秒跑出 5 秒 1080p,这个数字两年前是科幻,今天是水电。但这一行干下来我最大的体感是:AI 没有替代剪辑师,它替代的是摄影师和群演——分镜、锚点、一致性、节奏,这些属于“讲故事”的判断,一步都省不掉。模型公司卷的每个“单次 15 秒”,最后都会被你用回“一次 5 秒”:因为镜头语言本来就是 5 秒一格。
你打算用 AI 视频干什么活儿?卡在哪一步?评论区聊一个具体场景,问得最多的那类,我下一篇拿真实项目跑给你看。觉得有用,点个“在看”,转给那个还在手动剪素材的朋友。
下一篇预告:Prompt injection——你的 agent 正在替你读垃圾网页。
※ ※ ※
资料来源
- ▪ 各模型能力与价格:Google Veo 官方模型页、OpenAI 帮助中心《What to know about the Sora discontinuation》(API 2026-09-24 停用)、Kling 官方文档与公开评测口径、ByteDance Seed 公开资料,2026-09 检索
- ▪ 图生视频 API 形态(异步任务 + task_id 轮询 + 临时签名 URL):阿里云百炼公开文档、fal.ai 聚合平台文档,2026-09 检索
- ▪ 文中实测:在作者本地环境(一台 Linux 云主机)用文生图 + 图生视频 API 于 2026-09-21 实际跑通,关键帧 20.1 秒、视频任务 91.9 秒、成片 1920×1080@24fps / 5.04s;终端输出为真实记录,端点与密钥已替换为环境变量占位符
- ▪ ffmpeg 用法:ffmpeg 官方文档(concat demuxer / subtitles 滤镜)
- ▪ 文中示例主机与网络地址均为 RFC 5737 文档保留地址,非作者真实环境;未使用任何作者真实服务器的运行数据与账号信息。
评论 (0)
登录 或 注册 后参与讨论。