5个AI新模型摆一张表:算力、价格、软肋(附选型指南)
昨天 Anthropic 发了 Claude Opus 5.5,把旗舰 API 价目砍到 $4/$20 每百万 token——而三周前 OpenAI 的 GPT-6 Astra 还挂着 $10/$50 没动。加上 8、9 月集中放出的 DeepSeek V4.1、GLM-5.3、Qwen3.8 系列,五家的输出标价最高差 116 倍,缓存读价差到 142 倍。
价格表变得比翻书快,但各家话术也跟着升级:一个说“激活参数只有你的十分之一”,一个说“缓存读取 95% 折扣”,一个干脆不晒参数只晒跑分。这篇把五个模型的底层账本摊开对一遍:算力从哪省、价格藏在哪、各自的软肋在哪,最后给一页选型表。
※ ※ ※
📖 导读
- ▪ 五模型速览表(先看全貌)
- ▪ 算力篇:三种省钱流派,参数规模 ≠ 账单
- ▪ 价格篇:116 倍价差与三个计费暗坑
- ▪ 特点篇:五个模型五张画像
- ▪ 扩展篇:自建部署、订阅套餐、跑分怎么读
- ▪ 一页选型表
※ ※ ※
一、先把五张牌摆桌上
两点先说清,免得后面读数打架:
第一,DeepSeek 的价格是“峰谷双轨”。 官方从 V4 系列开始搞峰谷定价,闲时是高峰的一半——高峰每百万输入 3 元/输出 9 元,闲时降到 1.5/4.5,缓存命中更是低到 0.05 元(缓存命中就是这段输入在它的服务器上有副本、不用重新算)。GLM 的编码套餐也有同款机制:工作日 22 点到次日 8 点、全天周末,积分半价。
第二,Qwen3.8-Max 走订阅不走出率。 百炼 Token Plan 个人版 39/139/499 元三档月费,额度内随便调用可抵扣全系模型;Flash 档才有公开按量价(¥1/¥3),比同量级对手便宜一个数量级。
※ ※ ※
二、算力篇:三家都在“少算”,但省钱的路子完全不同
这轮发布最容易被忽略的主线,其实是个工程故事:怎么让每百万 token 背后的浮点运算变少。 五家给出的答案分三个流派。
流派一:稀疏化——把“查字典”从 GPU 里搬出去
阿里 8 月 26 日开源的 Qwen3.8-Flash 是这两年最激进的一份工程答卷,官方话术直接是“训练成本只有上一代 Plus 的九分之一”。拆开看三招:
第一招,把 embedding 拆出去。 传统 Transformer 的 embedding 层就是一张巨大的词表查找表,参数动辄占模型总量的 10% 上下,但它本质是“查表”不是“计算”。Qwen3.8-Flash 把一张 51B 参数的 N-gram embedding 拆成独立模块(官方原话:“将知识记忆外置到廉价存储介质”),推理时 offload 到主机内存、异步预取——GPU 的显存预算就省下来专门留给真正的计算。
第二招,激活参数压到 6B 量级。 主模型 125B,每 token 只激活约 6B。对照 DeepSeek V3 当年“671B 总量/37B 激活”的配置,激活率直接从约 5.5% 干到不到 5%——注意这不只是 MoE 路由更狠,而是配合上面的外挂 embedding,把知识存取从参数规模里剥离出去了。
第三招,注意力算子重写。 长上下文最烧算力的是 attention 对历史 token 的全量扫描。Qwen3.8 系列用的是“GDN 线性压缩历史 + QSA 稀疏挑选”的混合方案——线性部分负责把远期历史压成摘要,稀疏部分用一个轻量 indexer 精排挑出真正相关的 token。官方在百万 token 序列上的实测是:prefill 提速 7.6 倍,decode 提速 4.9 倍,而 needle 测试精度几乎不掉。
一句话:这是把数据库索引那套思想,搬进了注意力机制。
流派二:摊薄——总量不动,每 token 少算
智谱 GLM-5.3 走的是经典 MoE 摊薄路线。但有个细节比架构本身更有信息量:GLM-5.3 没有重新预训练。官方文档明说它和 GLM-5.2 是同一个 753B MoE 底座,全部提升来自“数十倍规模的长程任务后训练”。效果是实打实的:Terminal-Bench 3.0 从 4.6 跳到 28.3,DeepSWE v1.1 从 46.2 到 66.9——底座没变,光靠强化学习把工程能力拉起来。
这条路的算力账很清楚:预训练一次性大投入已经被 GLM-5.2 摊掉了,后训练再大也只是前者的零头。 价格也因此纹丝不动:$1.40/$4.40,和上一代一模一样。
DeepSeek V4.1 同理——V4 系列四月预览、八月出 Pro 正式版,V4.1 的 Flash 档全面开放后延续峰谷定价,第三方评测还传它把显存需求进一步压低了(这个数字没有官方口径,仅供参考)。它的省钱方式一直是业界最朴素也最有效的一种:把闲时算力卖便宜。
流派三:闭源双雄——不聊参数,只聊“每任务成本”
OpenAI 和 Anthropic 这一轮都没公布参数规模。但 Anthropic 的发布话术值得细品:Opus 5.5 的“账单降 40%”不是靠单价——$4/$20 相对 Opus 5 的 $5/$25 只降了 20%——另一半来自“每个任务消耗的 token 更少”,也就是推理链效率。 这是典型的“不告诉你我有多少参数,但告诉你我的每任务成本”叙事,把战场从参数规模引到真实体感。
两家在架构上倒是罕见地同频:GPT-5 时代引入、Astra 延续的“跨上下文窗口持续做笔记”机制(Codex 里实验性开放,早期窗口保持可搜索),和 Anthropic 一贯的“中间过程写成文档、不占上下文”打法殊途同归。2026 年长程任务的共识方案已经浮出水面:上下文当 RAM,文件系统当硬盘。
一句话:流派一、二在拼“每 token 算力”,流派三在拼“每任务 token”。三条路都在给同一张账单做减法。
※ ※ ※
三、价格篇:116 倍价差只是台面,台下有三个坑
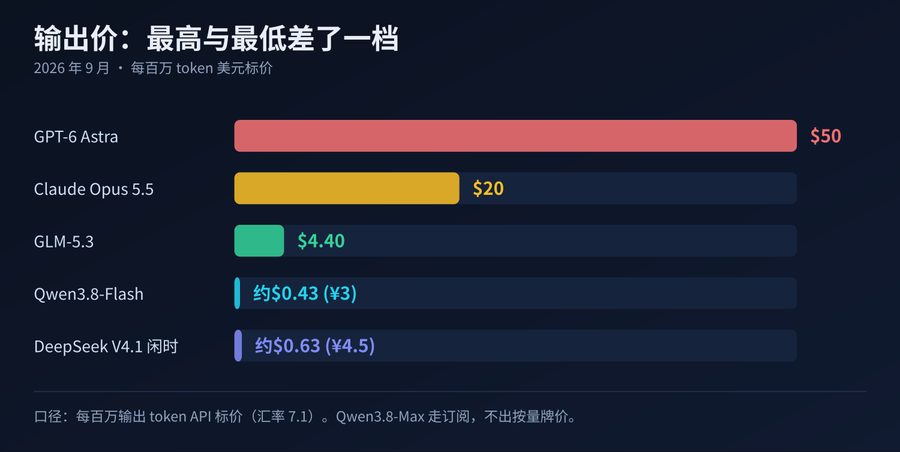
把五家的输出标价排个序(Qwen/DeepSeek 按 7 元汇率折美元):
- ▪ Astra:$50
- ▪ Opus 5.5:$20
- ▪ GLM-5.3:$4.40
- ▪ Qwen3.8-Flash(¥3):约 $0.43
- ▪ DeepSeek flash 闲时(¥4.5):约 $0.63
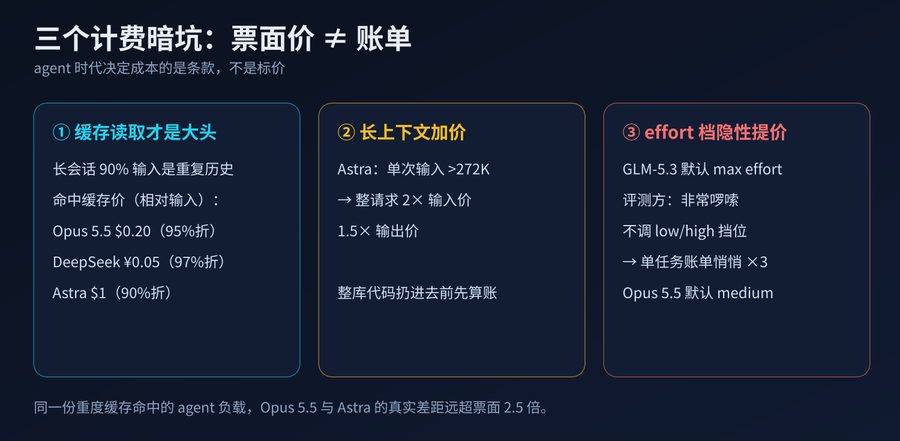
最高最低差 116 倍,就算只比两家闭源旗舰也差 2.5 倍。但直接拿这张表做预算会翻车,坑在缓存和折扣条款里:
坑一:缓存读取才是 agent 时代的大头。 长会话里 90% 的输入都是重复历史,命中缓存的价格决定真实成本。Opus 5.5 把缓存读价从 $0.50 砍到 $0.20,相对输入价折扣从 90% 干到 95%;DeepSeek 缓存命中 0.05 元,相对输入价折扣 97%;Astra 是 $1,折扣 90%。同一张账单,重度缓存工作负载下 Opus 5.5 和 Astra 的差距远不止 2.5 倍。
坑二:Astra 有长上下文加价。 单次请求输入超过 272K token,整个请求按 2 倍输入价、1.5 倍输出价计费。把整库代码扔进去跑长任务之前,先想想账单。
坑三:effort 档位是个隐藏定价器。 GLM-5.3 默认 max effort,独立评测方直接提醒:这货非常啰嗦,日常任务不调到 low/high 的话,单任务账单“悄悄翻三倍”。Opus 5.5 默认 medium、Astra 默认 low,两家倒是厚道些。另外两家闭源都卖“加速档”:Astra 快速模式 $20/$100(双倍价格换双倍速度),Opus 5.5 的 Fast mode $8/$40。
国内两家没有这些弯弯绕:峰谷明码标价,Token Plan 一口价订阅。对中小团队,“可预测”本身就是性价比。
※ ※ ※
四、特点篇:五张画像与各自的软肋
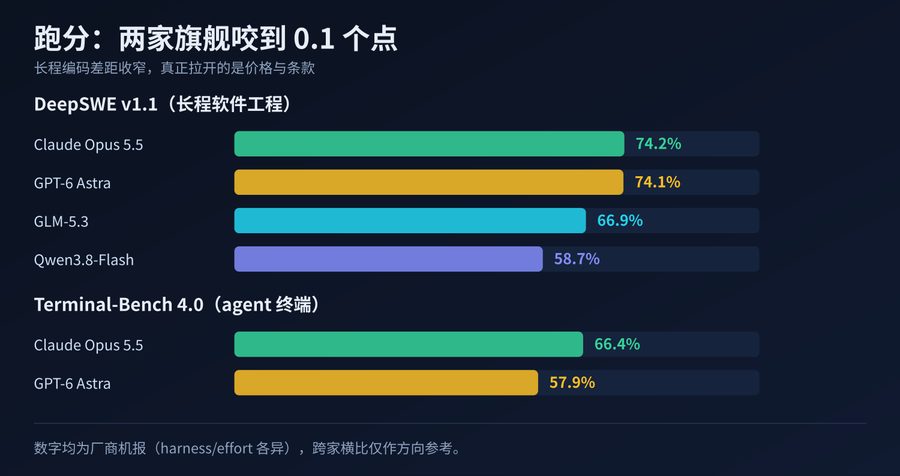
GPT-6 Astra:卖的是“会用电脑”。 官方主打 computer use——像人一样直接操作软件界面,OSWorld 2.0 离线子集 72.6%(上一代 Sol 是 65.7%),且单任务耗时约 40 分钟比 Sol 的 75 分钟快了 47%。编程长程任务同样在线(DeepSWE 74.1;Terminal-Bench 4.0 OpenAI 自报 57.7,Anthropic 图表里同项给 Astra 记 57.9——各家口径自家不同,下文细说)。软肋:$10/$50 是全场最贵,1.05M 上下文听着最大但有 272K 加价条款,独立智能指数 61 只与上一代 GPT-5.6 Sol 打平、落后 Fable 5.1。适合预算不敏感、要做 RPA 类桌面自动化的团队。
Claude Opus 5.5:把旗舰价打成中端价。 昨天刚发,Anthropic 官方定位是“多数工作上接近 Fable 5.1,但比 Opus 5 省 40%”。自报跑分很硬:Terminal-Bench 4.0 66.4%(同场 Astra 57.9)、CursorBench 57.8%、HLE 带工具 67.7%;独立评测 Artificial Analysis 新版智能指数给它 58 分登顶(Astra 同榜 53)。输出速度比 Opus 5 快 30% 以上。软肋:thinking 不能关、思考块格式和 5 代不兼容(官方列了 4 个 breaking change),生产安全护栏在网安/生物类任务上会静默降级到旧模型。适合长程 agent 编码和严肃知识工作。
GLM-5.3:“零元购”式升级,安全圈顶流。 同底座 + 重后训练,编程和安全两条线提升最猛(CyberGym 84.5%,发布前两周帮安全团队发现 2404 个潜在漏洞,包括一个潜伏 40 年的 DNS 协议级风险)。8 月 25 日开放权重(GLM-5.2 是 MIT),Terminal-Bench、DeepSWE 两项拿过开源第一。软肋:默认 max effort 的啰嗦账单,见上文坑三;无原生视觉。适合要私有化部署、或者盯上它漏洞研究能力的团队。
Qwen3.8 双档:一旗舰一屠夫。 Max(2.4T/激活 95B)主打端到端长程交付,官方口径“仅次于 Fable 5”,9 月 2 日的 0902 更新把 TerminalBench 3.0 从 11.3 拉到 29.0;订阅套餐制,个人版最低 39 元/月。Flash(8 月 26 日开源)就是上文算力流派一的主角,¥1/¥3 的定价摆明是去抢所有“高频便宜调用”场景。软肋:Max 没有公开按量价,账单灵活度不如竞品;Flash 是 Qwen4 架构预览,激进意味着踩坑面广。适合国内合规环境、以及用订阅把月账单锁死的玩法。
DeepSeek V4.1:把价格战打成基础设施。 1M 上下文、最大 384K 输出、峰谷定价、缓存命中 0.05 元——V4 四月预览时喊的“百万上下文普惠”现在成了事实标准。V4.1 Flash 九月全面开放后,flash 档 agent 能力官方称暴涨 6 倍、价格是 Claude 的 1/90。软肋:默认思考模式切换要显式配置(官方文档专门给“非思考/思考切换”一节,就是被问烦了的证据);高峰时段价格翻倍,重度使用要会排班。适合海量调用、批处理、成本敏感的所有场景。
※ ※ ※
五、扩展篇:三个务实问题
1. 哪些能私有化部署,门槛多少? 开源阵营里 GLM-5.3(753B)和 Qwen3.8 系列权重已公开。粗算显存账:753B 按 FP8 量化要 750GB 上下,得 8 张 H200/141G 或者同等组合;Qwen3.8-Flash 因为激活只有 6B 量级、embedding 外置,官方明说 FP8 版“大幅降低本地部署门槛”——社区已经出现把它蒸馏到 3.9GB 内存跑在 iPhone 上的衍生版(Bonsai 27B,基于上一代 Qwen3.6)。单卡 48G 工作站跑 Flash 档推理,现在是可行的。
2. 订阅制会不会把按量计费打穿? 我倾向于是。百炼 Token Plan 39 元/月起可抵扣全系模型,GLM 编码套餐按积分计费——这种“包月自助餐”对个人开发者的实际成本,已经低于任何一家按量 API。2026 年个人开发的默认姿势正在变成:重活(代码库重构、长报告)买旗舰按量,日常循环全塞进订阅。 各家按量价的持续下调,某种意义上是被自家订阅逼的。
3. 跑分怎么读? 这轮发布暴露一个新常识:官方跑分不可跨家横比——Anthropic 自报 Opus 5.5 的 Terminal-Bench 66.4% 和 OpenAI 自报 Astra 的 57.9%,两家的 harness、trial 数、护栏状态都不一样;更微妙的是 Anthropic 的生产护栏在网安任务上会静默回退旧模型,自报分数还因此偏保守。看分先看三件事:谁跑的(第三方 Artificial Analysis 最新一版智能指数给 Opus 5.5 评 58、Astra 评 53——同榜分才能对线)、effort 档位、以及是否带生产护栏。
※ ※ ※
六、一页选型表
价格与跑分截至 2026 年 9 月 23 日,以各家官网为准。选型没有银弹,但有一张表就够了——先把账单口径对齐,再谈感情。
明早同一时间发下一篇:用 AI 给一家五口排了趟北京,攻略就一张表——老人走得动的路线、孩子免票的门槛,把旅行变成结构化问题。
你被哪家的价格坑过?评论区聊聊,挑典型的展开写一篇。 觉得有用的话,点个「在看」让做预算的同事也看到。
※ ※ ※
资料来源
- OpenAI GPT-6 Astra 发布公告与 LLM Stats 模型卡片(2026-09-03/04);datanorth.ai 发布解读
- Anthropic《Introducing Claude Opus 5.5》官网(2026-09-22)与 Claude Platform 模型文档;Artificial Analysis 独立评测文章
- 智谱 GLM-5.3 官方发布报道(新浪财经,2026-08-15)、morphllm/ai-tldr 模型档案、bigmodel.cn GLM-5.3-Flash 文档
- 阿里 Qwen3.8 发布报道(GIGAZINE 2026-07-21、news.iresearch 2026-08-03、Pandaily 2026-08-27)、tech-insider 对比文(2026-09-05)、阿里云百炼模型定价页
- DeepSeek 官方 API 定价文档与 V4/V4.1 发布公告(2026-04-24、2026-08-13)、orcarouter V4.1 Flash 定价解读
- 汇率折算按 1 USD ≈ 7.1 CNY 粗估;文中价格均为发布时公开标价
- 文中图表为本文作者自绘;DeepSeek V4.1 显存占用“降至 1/4”为第三方评测文章说法,无官方口径,已在文中标注
评论 (0)
登录 或 注册 后参与讨论。