[F6]AI 作曲的天花板,卡在了曲式上
教材表述依据高为杰、陈丹布编著《曲式分析基础教程》(高等教育出版社);论文信息取自 arXiv 摘要与 README;产品信息取自官方发布页。全部网络信息查证日期 2026 年 9 月 24 日。
AI 写的歌,越来越像真的了。人声有气口,吉他有推弦,合成器的音色放在流媒体歌单里,很多听众已经分不出是不是人唱的。
但有一点我一直说不清:多数 AI 歌听完三分钟,像听了三分钟同一段循环。它不跑调,也不难听,就是“没有地方”:开头不知道要去哪儿,结尾不像从哪儿回来的。
这个问题不是旋律写作的问题,也不是音色的问题。我猜测,它卡在另一层:曲式。一个三百年的分析学科,恰好精确命名了 AI 现在缺的东西。这篇想用高为杰、陈丹布编的那本《曲式分析基础教程》当体检表,逐层对照:AI 做到了哪一层,卡在哪一层。
※ ※ ※
📏 先把标尺立起来:曲式学到底在管什么
先立标尺,否则后面说的“露怯”就成了主观口味。
高为杰教材开篇给曲式下的定义,我印象很深:曲式即“音乐过程的结构”——或同或异的音乐事件,在一个有起有止的时间过程中按一定逻辑分布、组合,形成的整体结构关系。研究这种结构规律的学科,叫曲式学。
注意“过程”两个字。曲式不是图纸,不是静态的形状,是在时间里铺开的因果:这里的重复是为了让那里产生期待,这里的转调是为了让后面的回归有重量。
教材十章的排列本身就是一条难度阶梯。我把它的骨架抄在这里,后面每一层都要用到:
这张表有两个关键洞察,比章节本身更值钱。
第一,判定靠的是功能性证据,不是表面听感。 教材里判断一段是不是乐段的结尾,看的是收拢终止、调性是否落回主调;判断再现部是否成立,看的不是“主题又响了”,而是“主题在预期的调性上、以预期的和声路径回来”。中间停一下叫开放终止,等着后面续上;停稳了叫收拢终止,告一段落。乐句之间的呼吸关系,就全写在终止式的类型里。换句话说,曲式分析从来不是“我觉得这段像副歌”,而是找证据:证据是终止式、是调性布局、是材料与位置的功能配对。这套判据的厉害之处在于可复核:两个人对同一段音乐的分歧,可以落到“这里的半终止算不算收口”这种能讨论的具体问题上。
第二,奏鸣曲式是这门课的珠峰。 它的本质是三件事叠在一起:主题之间的戏剧性对比、把这些对比拆开揉碎重新组织的展开部、以及最后让调性矛盾在再现部里得到解决。教材的口径叫“对立统一”。呈示、冲突、解决,这是十八世纪以来西方音乐最硬核的长程组织逻辑。注意奏鸣曲式里每个环节都是“为后面服务”的:副部之所以必须落在属方向,是为了给再现部“副部搬回主调”那一下解决留出空间;展开部之所以把主题切成小组动机到处移位,是为了消耗呈示部攒下的张力。也就是说,听奏鸣曲式里的任何一分钟,意义都不在这一分钟之内,这是它和“好听的段落串烧”的根本区别。一首奏鸣曲要在十几分钟里让听众听见这个弧线,靠的不是任何一个瞬间好听。
教材课后题的常见形式是:听一段乐曲,判断它的曲式。 请记住这个动作。它今天的学名叫 Music Structure Analysis(MSA),音乐信息检索领域的一个正式任务分支。AI 现在能不能替你把这套听辨题做了?这就是接下来要查的事。
※ ※ ※
🩺 现场一:使用层已经在“手动撑结构”
先看最表面的一层:AI 音乐产品到今天,都在用什么办法让一首歌不散架。
Suno 和 Udio 的歌词输入框,本质上是一张手填的曲式图。 你在歌词里要自己写 [Verse]、[Chorus]、[Bridge]。这些方括号标签就是段落功能标记:你告诉模型“这里进主歌”“这里副歌回归”。你不写,它大概率不主动制造。
看图 2 左边,这是教材里三段曲式的样子:A 段在属方向收口、B 段对比、A' 回来时收拢终止 + 主调回归。右边是大量 AI 歌的典型样子:全曲只有一个和声语汇在原地打转,标签是歌词里的 [Chorus] 撑出来的,模型本身并不知道什么时候该回去。
Udio 的官方工作流干脆承认了这件事。 它的帮助文档里有个功能叫 Extend:从任意时刻往下延长 30 多秒,“Stack multiple extensions to shape a full composition”——把多个片段叠起来搭成整曲。这是官方口径的“分段搭建”。结构不在模型脑子里,在人的时间线上。
Suno 在 2026 年 8 月 13 日发布的 Studio 2.0,是最有意思的一个侧面。 这次更新把浏览器里的 Studio 改成一台完整的 DAW:MIDI 录制、piano roll、MIDI 作为提示输入、stem 分离、多轨导出。它没有吹“模型更懂结构了”,它选择把结构控制权交还给人。产品层面,这等于承认模型自己握不住长程结构。
一句话总结这一层:AI 音乐的曲式,目前是人在模型外面替它持有的。
※ ※ ※
🩺 现场二:三种病理,用曲式学的语言命名
“AI 写的歌没结构”是模糊的抱怨。曲式学的好处是:它有词汇把这句话拆成三种不同的病。我把最常见的三种列出来,每种都对着教材的判定标准讲。
病一:副部失踪
教材里,二段、三段、奏鸣曲式成立的前提,都是对比并置:要有新材料、新调性、新陈述方式进来。奏鸣呈示部更极端:主部在主调,连接部要转调,副部通常在属方向(或其它对比调性)上出现,形成一对有调性落差的矛盾。
AI 生成的流行曲里,最常见的是全曲只有一个和声语汇从头转到尾:主歌副歌用的是同一套进行、落在同一个调、连能量起伏都是靠配器加层堆出来的。这不是“副部写得不好”,是根本没有发生过转调事件。功能事件缺席了。
病二:假再现
比“没有对比”更隐蔽的,是“回来的不是地方”。
教材判断再现是否成立,依据的是收拢终止 + 主调回归:主题必须在主调上、以闭合的和声路径回来,听众才有“回家感”。AI 生成的曲子经常在第 60 小节确实回到了开头的旋律,但停在属和弦上,或者整段移了一个关系不明的调,或者前一段根本没有“出发”过,回来也就无从谈起。
它学到的是表面重复,不是功能回归。主题响了,但结构上没有“再现”这件事发生。听感上,这类段落让人莫名松不下来,又不知道为什么。
病三:展开部缺失症
这是我认为最致命的一种。教材讲展开部有一句很硬核的话:将主题材料分组、逐渐化整为零,是展开的典型现象;展开段内部调性游移、不稳定,是它的常态。展开部的作用是把呈示部的矛盾真正拿去折腾一遍,让再现部的回归成为“折腾之后的结果”,而不是“时间到了”。
AI 曲子里,主题出现三遍是常态,但每一遍都是原地复制:不拆分、不移调、不重组、不制造新的紧张。于是全曲没有“发展”,只有“复读”。开头挖的坑,结尾根本没填。
三种病理合起来,就是那种“三分钟听完像听了三分钟循环”的根源:局部每一秒都连贯,全局没有发生过任何功能事件。
机理层面一句话能说清楚。自回归的音频模型,注意力窗口和训练目标都是“下一帧/下一 token 预测”。它天生拟合的是局部统计规律。而曲式恰恰是分钟尺度的全局函数:一个段落是不是“再现”,不由它自身决定,由它和前面若干事件之间的功能呼应决定。这个定义方式,正好落在 loss 看不见的尺度上。
再往细里说一层:训练数据里其实“有”曲式。经典录音的乐谱、流行歌的段落标注、乃至模型自己从数据里学到的统计规律,都在告诉它“副歌一般会第三次出现”。所以 AI 会模仿曲式的形状:在统计合适的位置放回主题、在合适的位置插入桥段。但它没有曲式的因果:它不知道那次回归为什么必须落在主调上,因为训练目标里没有“调性是否解决”这个量。形状可以背,因果只能算。这就是为什么 AI 的“再现”经得起听、经不起分析:你按教材的判据去检查它,证据往往不在场。
这不是孤例。LLM 写长文“开头挖坑结尾忘”,是同一个 bug 换了个模态:目标函数没有把全局约束建模进去,模型就只会做局部插值。
※ ※ ※
🔬 转折:MSA 这条线,正在把曲式学喂给机器
批评容易,接下来是这条线真正在发生的事。有一群研究者正在做的,恰好就是教材第一章那套听辨题,只是任务名换了。
SongFormer:一段 420 秒的视野
SongFormer(arXiv:2510.02797,2025 年 10 月提交,代码 CC-BY-4.0 开源在 github.com/ASLP-lab/SongFormer)是这条线目前最完整的一个工作。它的做法里有两处让我眼睛一亮,因为那正是曲式分析的动作。
第一处是双分辨率。 它同时融合两种自监督音频表示:30 秒短窗(抓细粒度局部)和 420 秒长窗(看全局上下文),再把 14 个互不重叠的 30 秒局部特征沿时间拼到长窗表示上对齐融合。曲式分析本来就是这个双视野:读乐句要贴到谱面上,读结构要退开看整曲。论文里的动机也很直白:已有的 SSL 模型大多在 30 秒窗口上预训练,把推理窗口直接拉长反而掉点。所以不能只把窗口拉大,得专门造一个全局视野。
第二处是两个头。 模型输出接两个任务专用头:边界头(哪里分段,二分类)和功能头(每段是什么:intro / verse / chorus / pre-chorus / bridge / inst / outro)。这个“先分段、再定功能”的结构,就是教材听辨题的标准动作。
配套数据也是这次工作的重心:SongFormDB 是号称规模最大的 MSA 语料(超过一万首,跨语言跨体裁),SongFormBench 是 300 首专家逐条复核的基准,其中 200 首来自 HarmonixSet、100 首是中文歌,顺带补上了 MSA 领域中文数据长期稀薄的短板。它的训练思路叫“异构监督”:把高质量人工标注、歌词对齐派生的伪标注、大模型生成的粗标注混合喂进去,靠一个“数据源嵌入”让模型知道每条数据可信到什么程度。
指标上,SongFormer 在严格边界检测 HR.5F(0.5 秒容差命中率)上刷到新 SOTA,超过了 Gemini 2.5 Pro。而它对通用大模型的评价非常具体:这些多模态大模型能产出结构标注,但它们的时间分辨率太粗,做不了精细分段。 论文原话大致如此。Gemini 在宽松容差 HR3F 上反而更好,在严格容差上明显掉。一个很干净的证据:语义上懂“这里有段副歌”,和时间上知道“副歌从第 47.3 秒开始”,是两回事。 前者是大模型的长项,后者是曲式分析的基本功。
但把它放回教材的标尺上,位置就清楚了
现在拿第一部分那把尺子量 SongFormer。
它的功能标签体系(verse/chorus/bridge……)在段落级,也就是教材里回旋曲式 A-B-A-C-A 那个层次,或者二段三段曲式的划分。这是曲式学的第一层:分段。
而教材更深的两层,它没有触及。其一是调性维度:终止式类型、调性布局、副部是否落在属方向、再现时调性是否统一。这层判定要的和声分析能力,MSA 现在的分段+贴标签范式压根不输出。其二是逻辑维度:奏鸣曲式那种“对立—展开—解决”的戏剧性关系,它涉及跨段落的因果判断,不是标签能表达的。
还有一个更结构性的落差:SongFormBench 的标注是扁平序列:一串带时间戳的段落标签,不做嵌套分组。而曲式学天然是层级的:乐句组成乐段,乐段组成乐章级部分,乐章级部分之间再构成曲式。教材分析一首奏鸣曲,画的是好几层括弧;今天 AI 输出的是一维列表。
所以现状可以概括成一句话:AI 已经开始会分段,还不会分析。 会分段,就是能回答“这里换段落了”;会分析,是回答“这个段落为什么在这里出现、它回来时为什么必须落在主调上”。中间隔着的,正是教材第八、九两章。
体裁这把钥匙,AI 领域刚开始补
再看一个更年轻的例子:EDMFormer(arXiv:2603.08759,2026 年 3 月发表)做的是通用电音的结构分段。它的问题意识很值得注意:通用模型在 EDM 上表现明显差,因为大多数 MSA 方法依赖歌词或和声相似度定位边界。这在流行歌里管用,在 EDM 里没用。EDM 的结构是由能量、节奏、音色的变化定义的,段落叫 build-up、drop、breakdown。于是作者自建了一套 98 首专业标注的 EDM 语料(EDM-98)和配套的标签体系,重新训了一个 transformer,drop 和 build-up 的分段才明显好转。
这条结论,曲式学一百年前就有了。教材第十章专门处理“其他曲式”:混合曲式、集中对称曲式、并列多部曲式,不同体裁有各自的结构逻辑,拿奏鸣曲式的框套一切是耍赖。AI 领域现在才通过一个个具体任务的失败,重新发现这件事。
补最后一块证据:arXiv 2512.17209《Do Foundational Audio Encoders Understand Music Structure?》系统地测了 11 种预训练音频编码器在 MSA 上的表现(ICASSP 2026 收录),结论指向:编码器之间差距很大,其中在音乐数据上用掩码语言建模自监督训练出来的那类,结构信息含量相对最高。 这反过来说明另一件事:通用音频表征里的结构信息不是天然就够用的,得专门挑、专门训。“结构”确实是被现有模型容易忽略的一个维度。
※ ※ ※
🛠️ 动手:给你的歌做一次曲式体检
概念讲完了。这一节给你两个能直接跑的东西。第一个不需要 GPU,也不需要装模型。
第一步:自相似矩阵,把结构画出来
曲式分析的核心动作是判断“这两段是不是同一材料”。有件仪器能把它变成一张图:自相似矩阵(SSM)。
思路很简单。把音频切成一帧一帧,每帧抽一个色度特征(chroma,12 个音级类的能量分布,它对音色不敏感、对和声轮廓敏感)。然后两两比较任意两帧的相似度,排成一个方阵。
怎么读这张图?重复的段落会在对角线两侧长出方块(第 40 秒的材料和第 100 秒的材料相似 → 对称位置上出现亮点);回旋结构会出现平行的亮条(每次主部回归,就留下一条与主对角线平行、间隔相同的亮带);一段糊到底的循环,就是一片均匀的雾。
# pip install librosa matplotlib numpy soundfile
# 用法: python ssm.py song.mp3   (输出 ssm.png)
import sys
import librosa
import librosa.display
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

path = sys.argv[1]                      # 任意 mp3/wav
y, sr = librosa.load(path, sr=22050, mono=True)
hop = 2048

# 1) 色度特征:对和声轮廓敏感,对乐器不敏感
chroma = librosa.util.normalize(
    librosa.feature.chroma_cqt(y=y, sr=sr, hop_length=hop), axis=0)

# 2) 自相似矩阵:色度归一后,点积即任意两帧的余弦相似度
S = chroma.T @ chroma

# 3) 高斯平滑 + 二值化阈值,让"段落块"更醒目(librosa 官方 SSM 套路)
from scipy.ndimage import gaussian_filter
S_s = gaussian_filter(S, sigma=[10, 10])
thresh = np.percentile(S_s, 90)

fig, ax = plt.subplots(1, 2, figsize=(11, 5))
librosa.display.specshow(chroma, y_axis="chroma", x_axis="time",
                         ax=ax[0], hop_length=hop, cmap="magma")
ax[0].set_title("chroma")
im = librosa.display.specshow(np.triu(S_s), x_axis="time", y_axis="time",
                              ax=ax[1], hop_length=hop, cmap="magma")
ax[1].contour(np.arange(S_s.shape[1]) * hop / sr,
              np.arange(S_s.shape[0]) * hop / sr,
              S_s > thresh, colors="cyan", linewidths=0.6)
ax[1].set_title("self-similarity (block chart)")
fig.colorbar(im, ax=ax[1])
fig.tight_layout()
fig.savefig("ssm.png", dpi=140)
print("saved ssm.png")
(核心三步:chroma → 两两点积 → 热图。第 3 步的 sigma 和 90 分位阈值是口味参数:段落看得不够清楚就加大 sigma,块碎了就降阈值。librosa 文档里 segment.recurrence_to_lag / lag_to_recurrence 那一套是它的进阶版,能压掉低频平滑只留真重复,这里不展开。)
我自己先用两个合成音频把这套仪器试了一遍:一段按“呈示(C)—对比转调(Am/F)—回归收拢(C)”铺的 27 秒小样,和一段四和弦循环六十四遍的“复读”小样。跑出来的图诚实地打了我的预期:两段都有亮块。因为循环本身就是最强的重复,四和弦绕 64 圈,矩阵上必然长出整整齐齐的平行亮条。真正的差别不在“有没有块”,在块的排布:有曲式的图,块与块之间大小、位置、间隔各不相同:呈示区、对比区、再现区各有各的相似半径;复读的图是一块基本模式沿对角线无限平移。色度矩阵测得出“重复”,测不出“回归”——想区分这两者,得再把和声进行的方向性(终止式前后关系)加进特征里。这一层坑我不替你的耳朵踩了,你自己跑一遍最直观。
我建议你做的对比:拿一首 Suno 生成的歌,再拿一首奏鸣曲呈示部的录音(贝多芬早期奏鸣曲随便挑一首,任何演奏版都行),各画一张自相似矩阵放一起看,然后用曲式学的眼光去问两个问题:主部、副部各自的区间里,块的对角线偏移了吗(偏移意味着换调,副部落在属方向,块就不会贴主对角线)?再现段是不是把呈示段的块搬回主对角线上(调性统一)?按教材判据的预期,奏鸣曲这两问都有清晰答案;而 AI 生成的流行曲,通常第一问就没有换调的偏移,全曲一个调,块全贴对角线。图就摆在那儿,比“我觉得它没结构”硬气得多。这只是个观察方法,具体图样取决于你选的样本和编曲密度,别当判词用。
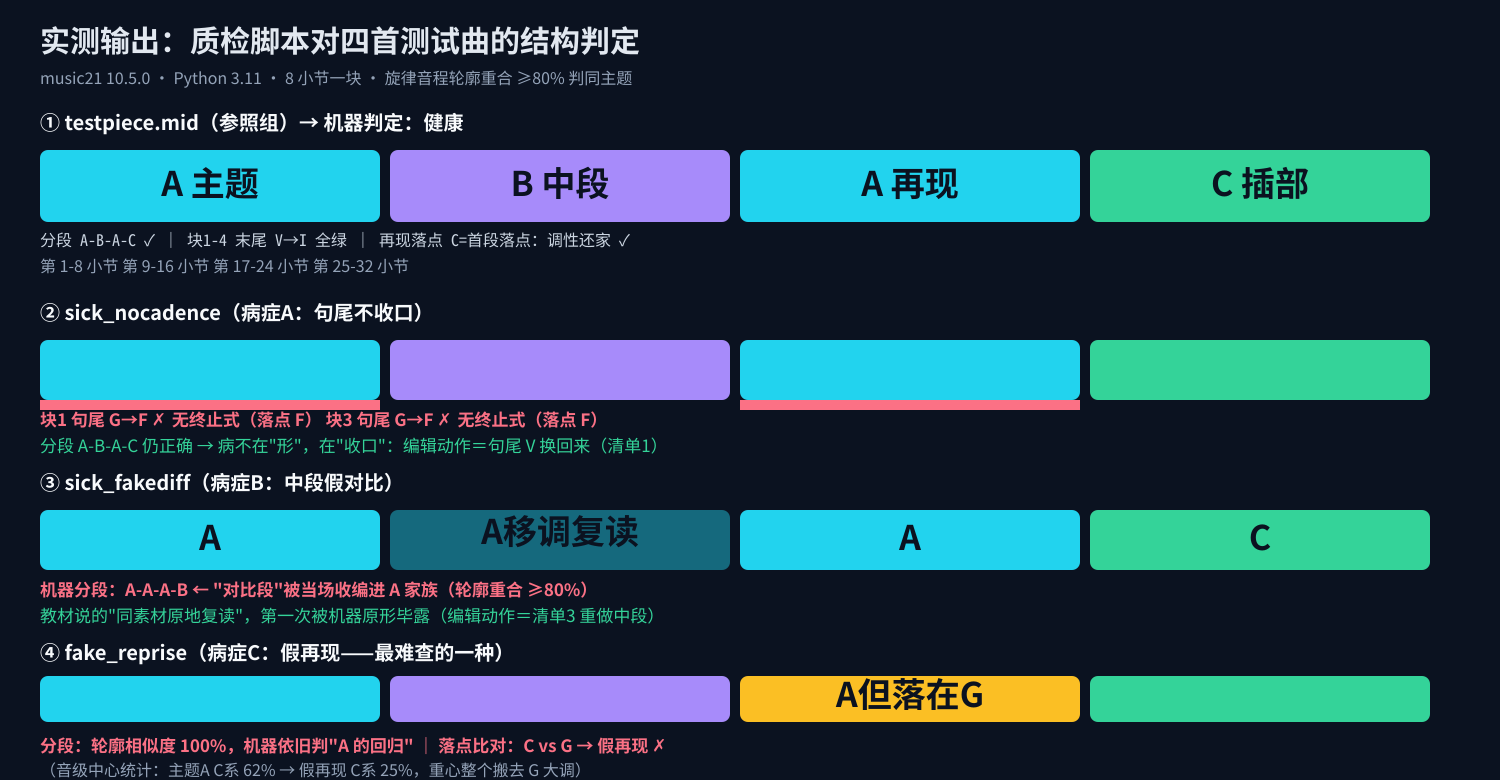
图 3 是我画的示意图(不是真实计算结果),只用来把“读图方法”说清楚。
第二步:SongFormer,让模型替你标段落
如果你想要机器给出的段落时间轴,可以直接跑 SongFormer。仓库在 github.com/ASLP-lab/SongFormer,有 HF Space 的一键推理入口,也有本地脚本。README 给出的路径大致是:clone 仓库并初始化子模块(它带 MuQ 和 MusicFM 两个第三方 encoder),conda create 建一个 3.10 环境,pip install -r requirements.txt,然后跑 src/SongFormer/utils/fetch_pretrained.py 下载预训练权重(国内环境 README 建议改用 hf-mirror,具体参数以仓库文档为准)。
批量标注用 src/SongFormer/infer.sh,主要参数是输入 scp 文件(每行一个音频绝对路径)、输出目录、模型名与 checkpoint 路径、GPU 数 ‑gn、每卡进程数 ‑tn。推理结果可以用仓库里的 src/SongFormer/utils/convert_res2msa_txt.py 转成标准的 MSA 文本格式,每行两列:秒级时间戳 + 标签:
0.0 intro
12.7 verse
47.3 chorus
78.1 bridge
...
end
拿到这份时间轴,你就能干一件教材里那种听辨题的变体:让模型标,你复核。 它标的每个 chorus 边界,是不是都对应一次你听觉上真实的段落回归?标出来“chorus”的那几段,和声上真的构成了重复还是只有音量上的抬升?这一复核,你就亲手测出了 AI 结构能力停在哪一层。
顺带说三种“从外面把曲式知识注入生成”的现有路子,都还粗糙:歌词 section tag(人肉填标签)、Suno Studio 2.0 的 MIDI-as-prompt(人肉画结构)、用外部 LLM 先规划 prompt 结构再喂给音乐模型(人肉的曲式外挂)。共同点是:约束全在人这一侧,模型目标函数里对“终止式”“调性回归”这类功能事件一个字都没提。 按这个思路推下去,下一代结构控制的 loss 要设计成什么形状,其实答案不在音乐生成圈里,在曲式学的判定标准里。我猜测,会写“下一小节”的 AI 遍地都是,会规划“整首曲子”的 AI 还没毕业。
※ ※ ※
🎼 那张毕业考卷,一百年前就印好了
回到最开始。
曲式学一百多年研究的,就是“音乐如何组织长时间”这一件事。它最有价值的遗产不是名词表,是那套硬证据:收拢终止还是开放终止、副部落在哪个调、再现时调性有没有统一、展开段有没有真的把主题化整为零。这些判定不依赖听感口味,可复核。
而这恰好是当下 AI 音乐最缺的东西:一个能算的、不靠“我觉得挺好”的评估指标。音色有 MOS,人声有相似度,结构有什么?HR.5F 测的是“边界准不准”,不是“结构成不成立”。我猜下一步会被造出来的指标,长得很像教材课后题的答案栏。
高为杰教材那套判定证据,很可能会变成下一代结构控制 loss 的设计图,因为它已经是这个领域里最严格、最可操作的一份“什么叫结构成立”的规范了。
最后一层不展开:会分段不等于会分析,会分析也不等于会写。AI 目前连前一步刚站稳,中间那一步(调性与终止式维度的功能判定)还没人认真做。所以别急着说 AI 已经懂了音乐,它现在开始懂的是“哪里换段落”。
那本教材第一章的听辨题,我复印在心里存了三年。哪天一个模型能报出“这是奏鸣曲式呈示部,副部在属调,结束部有补充终止”,不用它生成任何音频,那才是它真毕业的时候。
下一篇预告:自动化最脆的一环不是模型,是你的定时任务
※ ※ ※
※ ※ ※
资料来源
- ▪ 高为杰、陈丹布编著,《曲式分析基础教程》(第三版),高等教育出版社。章节脉络与定义取自该教材目录及各章要点;本文未引用具体页码。注意另有高为杰、吴春福《曲式与作品分析基础》(人民音乐出版社),本文未涉及。
- ▪ SongFormer: Scaling Music Structure Analysis with Heterogeneous Supervision,arXiv:2510.02797(2025-10-03 提交);代码 github.com/ASLP-lab/SongFormer(CC-BY-4.0);数据集 SongFormDB、基准 SongFormBench 托管于 Hugging Face。查证日期 2026-09-24。
- ▪ EDMFormer: Genre-Specific Self-Supervised Learning for Music Structure Segmentation,arXiv:2603.08759(2026-03-08,CUCAI 2026),EDM-98 数据集。查证日期 2026-09-24。
- ▪ Do Foundational Audio Encoders Understand Music Structure?,arXiv:2512.17209(ICASSP 2026),11 种编码器对比。查证日期 2026-09-24。
- ▪ Suno Studio 2.0 发布信息:官方 Release Notes 与 Studio 2.0 博客页,2026-08-13。查证日期 2026-09-24。
- ▪ Udio Extend 工作流描述:官方帮助中心 “Extend Your Song”。查证日期 2026-09-24。
- ▪ 本文自相似矩阵示例代码在本地 librosa 环境实跑通(脚本见正文,环境为 Python 3.11 + librosa 0.11);图 1、图 3 为作者手绘示意图,非真实计算结果。文中示例主机信息均为文档保留地址,非作者真实环境。
评论 (0)
登录 或 注册 后参与讨论。