[F3]给娃做了个背古诗App,第14天他主动要账号
一个小学生产品把坑踩全了:75 首教材诗、服务端判卷、三道防刷闸门、拼音逐字对齐。这篇只讲技术选型和判分设计,完整代码与数据库不放。
先说结果:我上二年级的儿子,连续 14 天每天主动打开这个 App 背诗,昨天跟我说“爸爸给我个自己的账号”。做这个之前,我在应用商店试了三个背诵类 App,第一个开屏广告 5 秒,第二个挖空答案是前端明文,他用开发者工具看了两分钟就跟我炫耀“这诗我全都会”。
那一刻我就决定了:自己写一个。
这篇是 AI 项目实战系列第一篇。全程一个人加一个 AI 结对,从第一行后端代码到今天 16 天,130 次提交,136 个测试用例。下面按踩坑顺序讲:选型、注音、判分、防刷。
※ ※ ※
📱 选型:为什么是 uni-app + FastAPI,不是小程序
第一反应当然是小程序,孩子iPad上即用即走。但小程序有两个月我绕不过去的坎:审核和类目。教育类目要资质,个人主体根本下不来;每次改动热修复要走审核,孩子第二天要默写的诗今天发现标错拼音,你等不了那几个小时。
所以选了一套源码三端可转的方案,先出 H5 部署在自己的服务器上,域名备案下来后直接切,将来想上小程序/App 同一套代码编译转端:
一句话:不为架构美感买单,为“改一个字第二天能生效”买单。
设备方向上定了一条铁律:手机竖屏、平板横屏,两套页面模板各端专用,不是响应式拉伸。平板竖屏持有时会弹一个旋转引导页。这条后来被验证是对的,孩子家 mostly 用平板,横屏双栏的答题体验跟竖屏根本不是一回事,硬用一套 CSS 适配,两头都别扭。
※ ※ ※
🔤 第一个大坑:拼音必须站在汉字正上方
教材古诗必须逐字注音,这事的复杂度远超我预估。三个坑连着踩。
坑一:分词错位。 用 pypinyin 整句取音,默认走词组模式(“两岸”读 liǎng àn 没问题),但诗句里的标点会把“第 i 个汉字对应第 i 个读音”的索引全部打乱。解法是先把整句切成「汉字段/非汉字段」,汉字段整段取音 zip 回字,标点原位留空。
坑二:多音字教材口径。 “远上寒山石径斜”的“斜”,pypinyin 按现代语境给 xié,但教材注释要求读 xiá 押韵;“白云生处有人家”的“生”不是“深”,这种是内容问题不是读音问题。最后落成一个覆写表:结构是 {诗题: {字: (读音, 第几次出现)}}。按“字+行内序次”而不是全局位置来定位,因为增删标点会让字符偏移漂移,而行内“这是第几个'斜'”永远稳定。通假字那类(“风吹草低见牛羊”的见读 xiàn)逐条查统编教材注释收进规则表,有争议的旧读只写注释不做覆写。
坑三:渲染层的物理定律。 拼音要在汉字正上方,最初用 flex 纵向单元(上 text 拼音、下 text 汉字)做等宽字格。但标点怎么办?把逗号做成独立字格,它的空拼音占位会把逗号视觉上顶到上排;把“逗号”并进前一个汉字的内联流(<text>鹅,</text>),字格容器垂直居中又把“鹅”字本体挤离格中心,拼音倒是居中了,两者错开。调 margin 救不了,这是布局物理:只要标点参与居中宽度计算就必歪。
最终修法:汉字独立 <text> 居中占格,标点绝对定位悬挂在字右缘(position:absolute; left:100%),不计入居中宽度。验收不靠肉眼,用 CDP 探针逐格断言 拼音中心x - 汉字中心x == 0,带标点的格子一起断。小格子的像素错位肉眼根本看不出,探针是唯一可信的裁判。
还有个连锁坑:七言诗一行七个字格,定宽格 ×7 超过手机正文宽度就折行。按该行汉字数分档缩格(格宽和字号同步缩),四档:≤5 字、6-7、8-9、10-12。验收时先在数据层断言,再真机看观感,无头浏览器里量宽度全是假象(视口固定小宽会把 flex 挤成竖排,截图跟真机完全两样)。
※ ※ ※
📚 75 首诗的入库血泪:标题会骗人,正文不会
选型和渲染都是前菜,真正让我返工最多的是内容:统编教材必背 75 篇,一篇都不能错。
最初我以为拿篇目表按标题去爬就行。跑完第一遍对账就傻了:《凉州词》有两首(王翰、王之涣),《绝句》有两首,《悯农》《四时田园杂兴》各有两组,教材里还带编号变体(《回乡偶书》在库里可能写成《回乡偶书·其一》)。按标题匹配,同名诗互相吞,改题变体全漏。
后来定的口径是正文指纹:每首取正文首句的前 8 到 10 个字(剥掉标点)当唯一键,全库扫描比对。标题只用来做人眼核对,绝不用来对账。唯一命中即入库,多命中拿作者消歧,零命中的才是真缺口,人工逐首核。一句话:内容系统的对账键要选“不会重名也不会被改写”的那一列,诗里就是正文本身。
抓取源的选择也是一课。第一个站正文卡片结构精美但脆,页面改版一次碎一片;换成从 <title> 提作者朝代、按固定小节标题切正文段落之后,管道三个月没碎过。每个 id 的抓取结果落一份 JSON 缓存,重跑跳过已有,网络断了接着跑。抓回来的译文赏析尾部混着“拼音有误?我来纠错”这类页面残骸,清洗锚点用特征正则一次性截掉,终扫断言全库 0 残留才许入库。
教育内容我给自己立了条铁律:任何一篇正文、任何一条注释,AI 默写的一律不算数。 AI 背诗会“自信地”改字,“白云深处有人家”还是“生处”这种一字之差,它敢给你编个出处。所有正文必须教材/多源交叉核准,AI 只干清洗、断句、格式化的活。断行口径后来也分了两套:诗词按逗号逐逗断行(教材版式),文言文按句末标点断、段内连读(“人之初,性本善”是一行不是三行)——两套规则喂反一次,整个库的行就全碎了,所以入库脚本里断行函数前面挂着文体判断。
※ ※ ※
⚖️ 判分为什么必须放服务端:前端给的答案,孩子五分钟就能破解
这个 App 的核心玩法是“挖空背诵”:整诗展示,随机一部分汉字挖掉,四个选项选一。判分如果在前端,答案数组就在响应里,等于没有判分。
所以定了一条架构红线:客户端永远拿不到“正确答案”这个字段,判分在服务端重算。
具体做法是自出卷可复现。挖空的位置、选项的顺序,全部由一个种子随机数生成器决定,种子是用户 ID、诗 ID、日期三者的哈希:
import hashlib, random

def _seed(user_id, poem_id, day) -> int:
    h = hashlib.sha256(
        f"poemapp:{user_id}:{poem_id}:{day}".encode())
    return int(h.hexdigest()[:12], 16)

def gen_quiz(lines, user_id, poem_id, day, homophones, reroll=0):
    rng = random.Random(_seed(user_id, poem_id, day)
                        + reroll * 7919)
    blanks = []
    for li, line in enumerate(lines):
        idxs = [i for i, (ch, _) in enumerate(line)]
        n = max(1, min(4, round(len(idxs) * 0.30)))
        for pos in sorted(rng.sample(idxs, n)):
            ch, py = line[pos]
            blanks.append({"line": li, "pos": pos,
                           "correct": ch,
                           "options": make_options(...)})
    public = redact(blanks)          # 下发前去掉了 correct
    key = {(b["line"], b["pos"]): b["correct"] for b in blanks}
    return public, key
孩子提交答案时,服务端拿同一种子重新算一遍题面,逐空比对。不存“当前会话答案”,判卷无状态,重放和篡改题面都没有落脚点。当天重背(reroll)换盐不换机制。
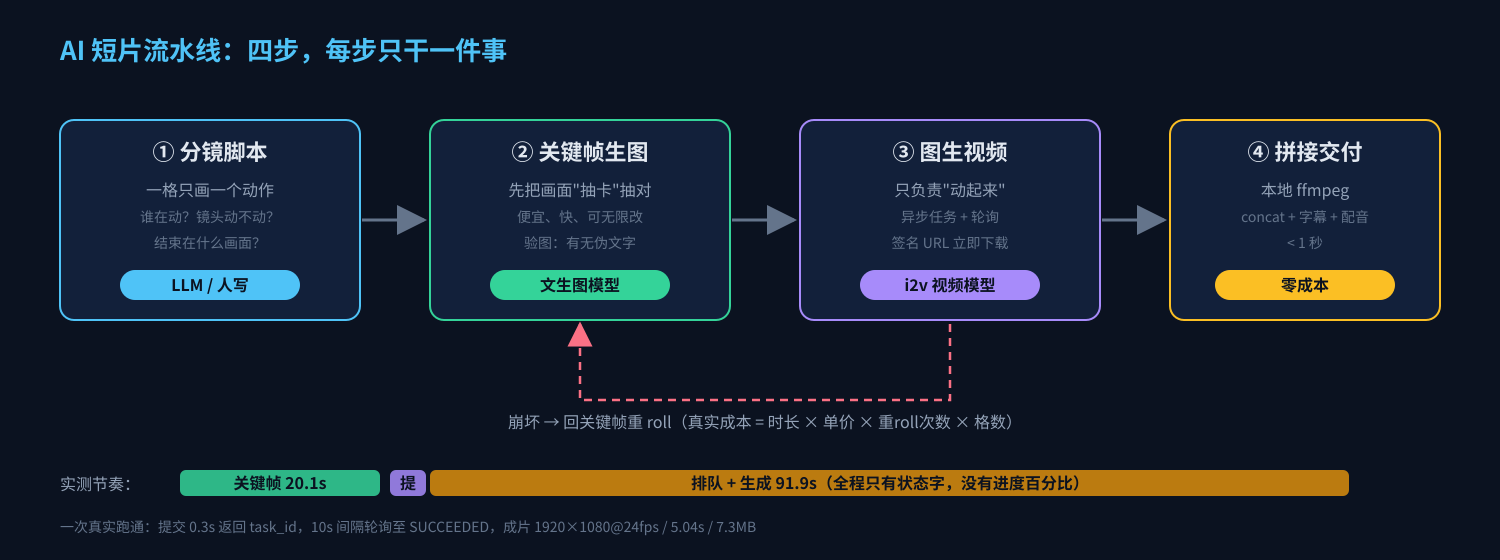
这里埋过一个非常隐蔽的雷:干扰项选项的随机数和挖空位置的随机数最初共用一个主 rng。后果是同音字字库一扩充,选项抽取把主 rng 的序列消费乱了,挖空位置跟着漂移,孩子页面上做的题和服务端重算出的题对不上,全卷误判。修法是每个空位派生独立的子种子(f“{seed}:{line}:{pos}:{reroll}”),主 rng 只管挖空。教训一句话:同一个随机流管两件事,其中一件的数据一扩容,另一件事就遭殃。
干扰项质量是产品灵魂。四个选项 = 正确字 + 带调同音字 + 去调同音字 + 形近字。同音字池不引外部字典,直接从诗库逐字注音里聚合,拼音到汉字集合,天然都是课本里学过的字;形近字维护一张教材常见错字表:
CONFUSES = {
    "已": ["己", "巳"], "己": ["已", "巳"], "候": ["侯"],
    "幕": ["暮", "慕"], "坐": ["座"], "州": ["洲"],
    "带": ["戴"], "升": ["生"], "作": ["做"],
}
孩子在这几个字上栽的跟头,全在表里。一句话:让干扰项“像那么回事”,比让题目变难更有教育价值。
※ ※ ※
🚧 三道防刷闸门:他为了刷积分能干出你想不到的事
背会通过给积分,积分能兑换小奖励(1 元等价 1000 积分的定价口径)。上线第一晚我就想清楚了:一个 motivated 的八岁孩子加上一个会 F12 的十岁表哥,就是攻击面。
防刷分三道闸,全部收口在判卷接口一个函数里:
闸门一:服务端签发的答题令牌。 题面下发时附带一个 HMAC 签名 token,内容含用户、诗、签发时间戳:
def qt_sign(payload: str) -> str:
    return hmac.new(SECRET.encode(), payload.encode(),
                    hashlib.sha256).hexdigest()[:32]
# token = f"{uid}:{pid}:{reroll}:{ts}.{qt_sign(payload)}"
闸门二:时间闸。 交卷耗时必须过门槛,门槛以服务端签发时刻起算,客户端自报的 duration_sec 只作记录、不作依据(可伪造):
def min_duration(total_blanks) -> float:
    return max(3, 2.5 * max(1, total_blanks))
    # 每空至少 2.5 秒,地板价 3 秒
一首 20 空的七绝,4 秒交卷直接 429:“答得太快啦,认真背完再交卷。”这一闸顺带封死了“脚本循环点选”路径:机器人可以秒答,但过不了物理反应时间。
闸门三:频控与配额。 滑动 1 小时判卷次数上限 30 次(含失败尝试),每首诗每天练习次数有上限,每日“新背得分”名额封顶 5 首。第三闸防的不是脚本,是肝:一个孩子如果一小时背 30 首换取积分,那是惩罚不是奖励,系统得拦住。
token 缺失或伪造的处理策略值得单说:判卷照常、积分清零、记一条守卫日志。不拒绝服务。因为旧版本客户端可能不带 token,崖式拒绝会把正常用户拦在门外;静默零分 + 日志,既能发现异常又不伤友军。
def gate_check(body, user, total_blanks):
    ok, ts = verify_token(body.quiz_token)
    if not ok:
        guard_log(user.id, "bad_quiz_token")
        return False            # 分数照算,积分不发
    if time.time() - ts < min_duration(total_blanks):
        guard_log(user.id, "too_fast")
        raise HTTPException(429, "答得太快啦")
    return True
※ ※ ※
📈 排行榜:最难的设计不是算法,是“别让孩子学会作弊”
榜单综合分五项加权:
W_RECITED = 15.0      # 每背熟一首
W_CHECKIN_DAY = 1.5   # 每个打卡日
W_REVIEW = 2.0        # 每次复习通过,每日封顶计 6 次
# 连签阶梯:≥3天×1.0/天  ≥7天×1.5/天  ≥30天×2.5/天
# 积分项按极小权重参与
权重集中一个文件,调口径只改一处。复习项挂钩艾宾浩斯间隔序列,背熟的诗按 1、3、7、15、30 天顺延到期,到期列表和徽章数字共用同一个“按诗分组取最近日志”的子查询。
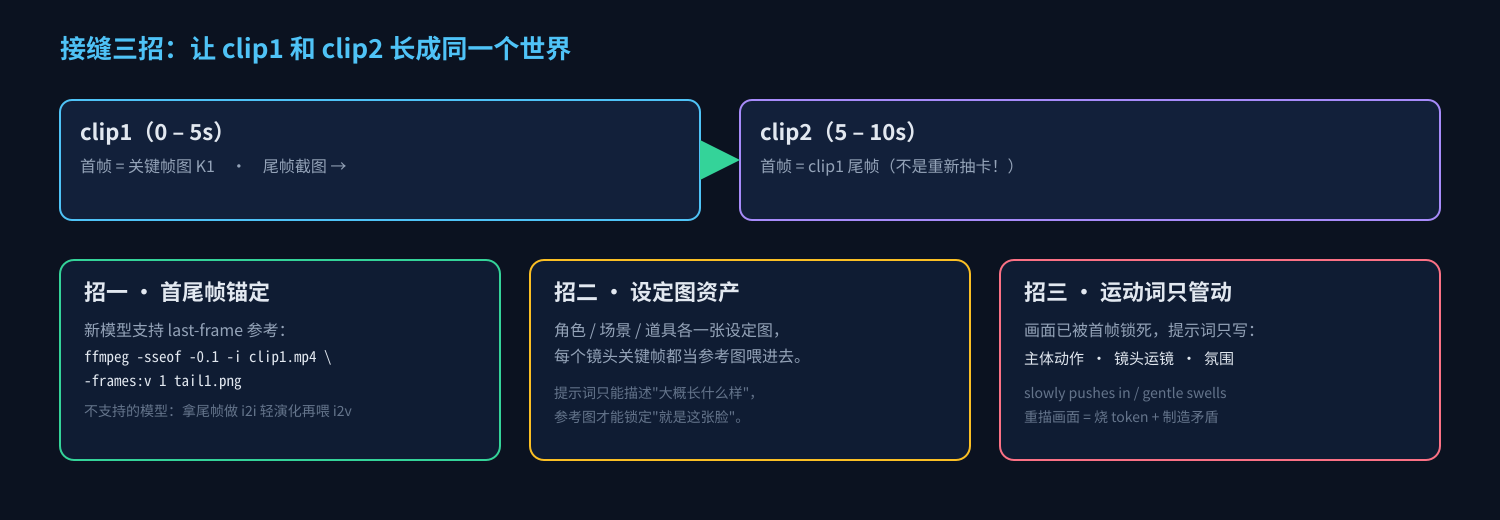
这个口径最初写岔过一次:徽章裸 count 日志行,复习每通过一轮写一条新 log,数字越滚越虚高,孩子会一首一首点进去跟你算账。展示层的每个数字都必须能点进去对上明细,儿童的直觉比产品经理敏锐。
飞花令对战模块跟 AI 打,三档人设:长安才女(手里 4 句)、洛阳进士(6 句)、金陵诗仙(不限)。令字从教材 75 首覆盖的字里优先抽,孩子打不过才女的时候,说明诗还没背熟,而不是系统坏了。
※ ※ ※
🚪 一次限流误伤:防机器人的墙,先拦住了真人
上线第三天,我儿子连背三首诗之后 App 报“请求过于频繁”。查出来是 nginx 层的限速被当成了主墙:一个页面加载本身就突发十几个同前缀的读请求,全家 WiFi 又是一个 NAT 出口共享一个 IP,限速 30 次/分钟直接误伤真人。
修完之后这套防线变成两层,口径写进了项目文档:防刷的主墙永远放应用层(游客按 IP 日配额、登录用户豁免、判卷走 HMAC 令牌),nginx 限速只当粗筛,拦“每秒几十路的拖库脚本”,rate 设到真人怎么点都撞不到。同一场误伤还暴露了一个前端分支缺失:带 token 被 429 和游客超配额是两回事,前者多半是 JWT 过期,提示语应该是“登录已过期,重新登录即可”,而不是把“今日免费额度用完”甩给一个已登录的孩子。一句话:任何一道闸,都要能分得清它拦的是谁,并且把这句话原样告诉被拦的人。
部署形态上还有个经典的“Chrome 打不开、微信能开”:app 只挂在 HTTPS 的 443 站下,80 口没配对应路径,浏览器自动补 http:// 就 404。修法是一行 301 整站升级。IP 直连的站证书自签,微信转发链接不抓缩略图也是这类环境限制的叠加,后来备案域名下来配了正经证书,一次迁走:新域名 vhost 沿用同一组 /app /api 前缀反代同一端口,构建产物零改动,双站并行过渡。
※ ※ ※
🧪 136 个测试,AI 结对开发的质量线
全程 AI 结对写代码,我的纪律只有一条:每个功能落地当天补 pytest 用例,136 个测试全绿才允许部署。时间口径这类全局陷阱就是测试兜住的,所有“今日/当天”的比较必须走同一个 timeutil(本地日换算 UTC 起点),SQLite 的 CURRENT_TIMESTAMP 存 UTC、Python 的 date.today() 是本地日,两个口径混用,每日限额会静默错位,防刷闸变成摆设。
一句话总结这套质量体系:凡是“闸”,必有回归用例证明它能关上;闸门没有失败用例,等于没有闸门。
※ ※ ※
写在第 14 天
回到开头那件事:他要账号的那天,我把 iPad 递给他,他自己注册、自己设了个“诗友007”的昵称,第一句是问“我能不能跟同学比赛”。产品的路线图瞬间被一个八岁用户改写了。
这 16 天里 AI 帮了我大概七成的工作量,但真正值钱的部分,是我知道哪里要立红线:答案不下发、时间不信客户端、每个数字对得上明细。AI 是个快得吓手的结对伙伴,红线画歪的时候,它不会提醒你。
下一篇预告:AI 项目实战②——《每晚 22:10,我的服务器自己给自己写投资日报》。一套 A 股量化监控系统里,市场闸门、因子评分、回测方法学三层是怎么分的,以及为什么说最难的不是策略,是让自己不骗自己。
※ ※ ※
※ ※ ※
资料来源
- ▪ 后端判分与防刷核心:示例项目自建 FastAPI 服务(出题引擎、判卷闸门、榜单评分、内容入库四个模块)
- ▪ uni-app 官方文档:Vue3 + Vite 工程线(H5 编译与条件编译)
- ▪ pypinyin 官方文档:Style.TONE 与 heteronym 模式
- ▪ 教材篇目依据:统编小学语文教材必背古诗文 75 篇(公开目录)
- ▪ 本文所有终端输出与数字(130 commits / 136 用例 / 阈值参数)来自作者本机项目仓库实测,示例主机与项目名均为脱敏改写,文中未出现任何真实服务器 IP、域名或账号信息;部署示意一律使用 RFC 5737 文档保留地址(203.0.113.0/24)
- ▪ 生成日期:2026-09-27
评论 (0)
登录 或 注册 后参与讨论。