OpenAI 把太阳月亮星星编成一家,又放了个通宵干活的点
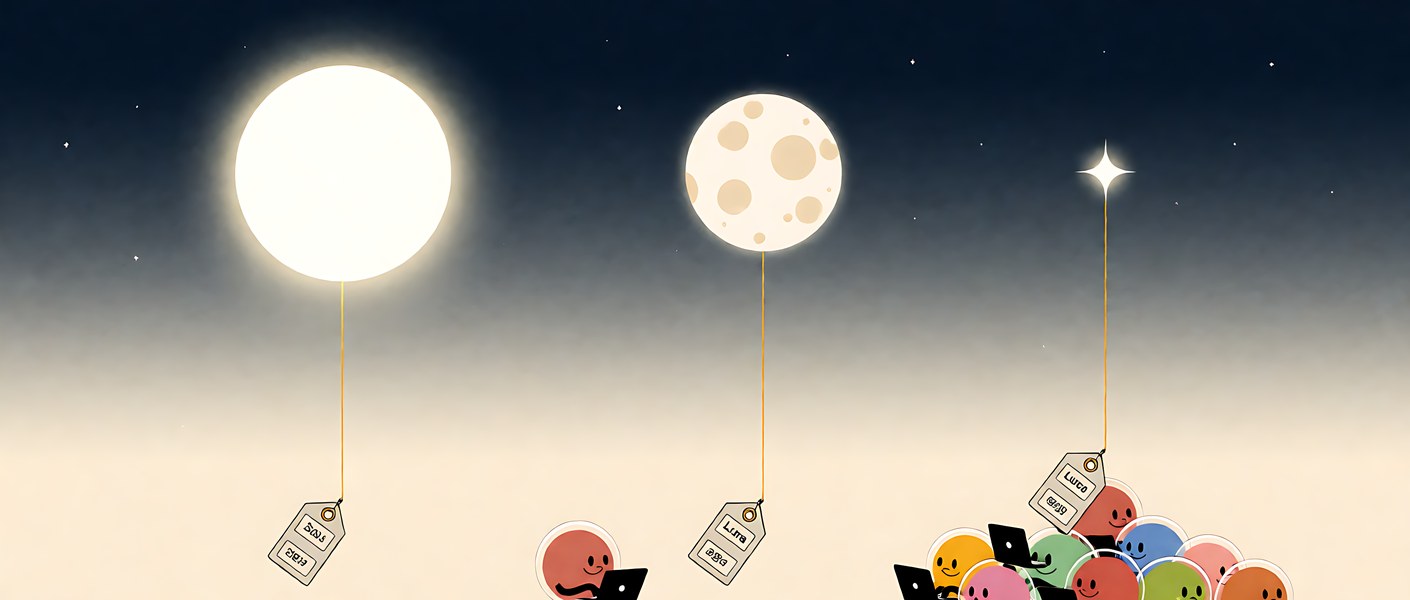
9 月这一个月,OpenAI 连发了三次东西:9 月 3 日的 GPT-6 Astra,9 月 22 日的 GPT-6 Sol 和 Luna,还有 9 月 29 日 DevDay 上的 Dots。发布会词一个比一个响,“AGI 时代”都喊出来了(Axios 的原标题)。我的第一反应不是牛逼,是先翻价格表。
翻完我承认,这次真让我坐直了。因为这家公司第一次把“智能”按水电煤的规格来定价了——一度电、一吨水、一档工业用电,明码标价,各取所需。这比任何 benchmark 数字都更能说明行业到了哪一步。
※ ※ ※
三个名字,三档电价
先说命名。Astra 是星,Sol 是太阳,Luna 是月亮。营销部这次难得没偷懒:名字本身就是产品说明书。
看官方 API 价目(每百万 token,美元):
从 Luna 到 Astra,输入价差一百倍。注意,这不是十年前的价差,是同一代模型、同一批论文、同一个九月里的价差。
更狠的是官方自己的对照:Sol 和 Luna 比三个月前的 GPT-5.6 同档直接降价 50%,理由是缓存和推理效率改进,“省下来的直接还给用户”。发布同一天,Amazon Bedrock 就宣布两款模型 GA(TechCrunch、AWS 官方通稿可查)——企业渠道一天打通,这不像新品,像基础设施交割。
我认识的做 agent 的人,过去半年的痛苦都绕不开一件事:任务链里 90% 的环节根本不需要旗舰模型,但架子搭起来了就换不下来,因为分类、抽取这些“小活”一旦出错,后面全崩。Luna 的定价等于承认了这个架构真相:一条 agent 流水线的合理形态,本来就该是 Luna 打底、Sol 干重活、Astra 只在真正难的节点出场。OpenAI 现在把三档都做好了,还带同一个 1M 上下文窗口——分层调用从一个你自建的能力,变成平台原生的一张账单。
※ ※ ※
基准测试的口径变了,这才是行内人该盯的
Astra 发布那两天,各家报的都是“第一”。Sol 和 Luna 这次,OpenAI 自己发的对比全是另一种句式:
- ▪ DeepSWE v1.1(真实代码库长任务):Sol max 档 68.8%,比 Claude Fable 5 的最高分 69.9% 只差 1.1 个百分点——但每任务成本低约 80%。Luna max 档 66.6%,和 Opus 5、Fable 5 的 medium 档相当,成本分别是它们的 7% 和 4%。
- ▪ OSWorld 2.0(电脑操作):Sol xhigh 档 60.5%,对 Opus 5 medium 档的 60.3%,赢一点点,便宜 80%。
- ▪ 事实性:内部评测(拿真实对话里用户标记过的事实错误回归测试),Sol 的错误率约为前代一半,“接近 Astra 级”。
看出来了吗?没有一项在争“世界第一”,每一项都在争“同分最低成本”和“同成本最高分”。发布材料的重心从能力曲线挪到 cost-intelligence 曲线,这不是文案风格问题,是竞争维度真的换赛道了。
这里有个普通读者容易错过、但做工程的人应该立刻拿小本本记下的旋钮:effort(推理档位)。Astra 支持 low/medium/high/xhigh/max 五档。第三方 Artificial Analysis 测过:同一个评测任务,low 档成本 $0.46,max 档 $1.67,差 3.6 倍;智能分只从 57 挪到 61。
翻译成大白话:模型厂的计费表上多了一个你亲手可以拧的龙头。以前我们说“换个便宜模型”,以后说“同一模型调低一档”。用哪个模型、拧到哪一档,会成为 agent 架构里和路由逻辑同等重要的一等公民。OpenAI 公告里 Sol 和 Luna 的分数都特意标了 effort 档位(“at max effort”“at xhigh effort”),行规已经开始变了。
※ ※ ※
星星的底座:十万张卡和一条看不见的思维链
再说 Astra 本身的两个技术注脚,都在维基百科和 Fortune 的报道里。
第一,训练规模。OpenAI 研究 VP Aidan Clark 对记者说,这是他们“by far”最大的一次预训练,第一次在得州 Stargate 基地用上超过 100,000 张 GPU。算力集中到这种程度,本身就在解释为什么它敢同时把下游两档砍到那个价——不是慷慨,是推理侧的成本曲线真的弯下来了。
第二,推理新法。Astra 用了一种叫 “recurrent depth”(循环深度,也叫 looped transformers)的技术,效率换智能。但同一段报道里跟了一句要命的话:这种方式会让模型的部分甚至全部思维链不可见。安全圈对模型可监控性(monitorability)的担忧立刻起来了——你没法审计一条你看不见的推理链。考虑到今年 7 月那次 Hugging Face 事件后 OpenAI 特意推迟发布加固护栏,这条线迟早会扯进监管讨论,先记下。
顺手提醒用 API 的朋友一个账单陷阱:Astra 的 1.05M 上下文是真给,但单次输入超过 272K token 后,整单请求按输入价 2 倍、输出价 1.5 倍计费。缓存输入便宜九成($1/M),可缓存写入要按 1.25 倍收。长上下文不是免费水库,是阶梯水价。
※ ※ ※
Dots:把我们自己搭的东西,包装成产品卖给白领
9 月 29 日 DevDay 的主角是 Dots。官方口径:always-on 的自主 agent,跑在 Astra 上,你给它一个目标、划定它能自己做什么的边界,它在自己独立的电脑上跨应用干活,两次对话之间持续推进,碰到需要你判断的事再回来找你。今天起在 ChatGPT 内向 Pro 和 Business Premium 用户灰度,从 Codex 或 ChatGPT 都能唤起;可以通过 Slack、Teams 给它派活;未来是“一队 dots 替你协同工作”。还能开“专科 dot”——单独给它配身份、凭据和工具,安全侧对接微软 Agent 365。
看起来眼熟吗?太眼熟了。给 agent 一台自己的机器、常驻调度、子任务分工、结果回收人审——这套东西,任何一个在 2026 年玩过 Codex、Claude Code 加 cron 的开发者都手搓过。OpenAI 官方自己的内部数据也佐证了 agent 化的烈度:研究员按 API 价折算的日均 token 消耗,中位数超过 $600,90 分位超过 $7,000(公告原文引的)。开发者早就这么活了。
所以 Dots 真正的动作不是发明了什么,而是两件事:
一是把 harness 零售化。卡通浮空的“点”形象、起名字、像发消息一样派活——TechCrunch 的标题很刻薄但精准:“bubbly agentic avatar”,对标 Meta 的 Muse。把终端里的东西变成小白领敢点的东西,这是产品力,别小看。
二是把常驻的模型定成了 Astra。注意这点的分量:always-on 意味着电表不停。跑在 $10/$50 的模型上的 24×7 agent,OpenAI 没有细说空闲计费怎么算,这是我觉得上线前必须盯的账单黑洞。吹“Dots 替你上班”之前,先问一句:它摸鱼的时候收钱吗?
※ ※ ※
一段可以直接跑的账
选型这种事,报数字最诚实。给你一个能贴进终端跑的算账脚本——按一个典型中等任务(输入 8K token、输出 4K token)算三个档的单任务成本:
prices = {  # USD per 1M tokens: (input, output)
    "gpt-6-astra": (10, 50),
    "gpt-6-sol":   (2, 10),
    "gpt-6-luna":  (0.10, 0.50),
}
IN, OUT = 8_000, 4_000          # 一次典型任务用量
DAILY_TASKS = 10_000            # 每天一万单

for model, (pi, po) in prices.items():
    cost = IN/1e6*pi + OUT/1e6*po
    print(f"{model:12s} 单任务 ${cost:.4f}  月账单(30天) ${cost*DAILY_TASKS*30:,.0f}")

# gpt-6-astra  单任务 $0.2800  月账单(30天) $84,000
# gpt-6-sol    单任务 $0.0560  月账单(30天) $16,800
# gpt-6-luna   单任务 $0.0028  月账单(30天) $  840
同样一万单一天,选错档,月底差出一台车。API 调用姿势没变化,model id 就是 gpt-6-sol、gpt-6-luna,OpenAI SDK 直接换名即可。架构上的正确打开方式也清楚了:分类、抽取、路由这类高吞吐窄任务全部下放 Luna;写代码、改仓库、跑 agent 循环给 Sol;Astra 只在真正需要“最难端到端”的节点出场——比如 Dots 那种长驻总控。顺带一提,DevDay 上还预告了 GPT-6.1 Sol,官方话术“接近 Astra 性能、成本更低”,说明档位本身也还在内卷。
※ ※ ※
对中国读者,这事有一层更近的意味
Luna 的 $0.10/$0.50 是什么概念?对比第三方目录里同期的 DeepSeek V4 Flash(约 $0.17 输入 / $0.35 输出)——输入价被追平了,输出价还在同量级。过去两年“美国前沿模型贵、国产模型便宜打市场”的默认分工,这个九月正式作废。前沿厂商开始亲自下场打低端价格带,靠的不是补贴,是缓存和推理效率的真实改进(他们官方降价理由写得很直白)。国内还在卷参数量的团队,该把工程重心挪到推理成本上了——这一仗的弹药不在训练集群,在 serving 层。
另一个眼熟的点:Luna 的定位(高频判断:分类、是非、抽取、带置信度路由)和我最近实测的百炼 decision-model-preview 几乎是同一个物种——决策层模型。OpenAI 用一整个产品档来回答的需求,国内用预览免费模型在试。这个细分会不会像 embedding 一样变成大厂标配,值得盯。
※ ※ ※
我的取舍:一张选型表和一句狠话
如果只留一张表给我自己用:
这个九月真正发生的不是“更强的模型来了”。是智能第一次有了清晰的批发价、零售价和阶梯价,然后 OpenAI 顺手把“雇个 AI 同事”摆上了货架。价格体系一旦立起来,卷的就只剩工程了。
最后留一个我到现在没找到答案、上线前必须替你们问的问题:Dots 的 dot 们可以组队协同,专科 dot 各自持身份持凭据。当半夜三点你的 dot 用你给的凭据做出一个错误但合规的动作——事故报告上签字的那一栏,写的到底是谁的名字?
作者:魏少冬
※ ※ ※
数据口径:定价与基准均引自 OpenAI 官方公告(openai.com/index/introducing-gpt-6-sol-and-luna、developers.openai.com 模型页)、TechCrunch 2026-09-22/09-29、AWS Bedrock 公告、Wikipedia GPT-6 词条及 Artificial Analysis 实测,检索时间 2026-09-30。
评论 (0)
登录 或 注册 后参与讨论。