别盯着 10 万亿参数了,Qwen4 真正该看的是那个 27B
9 月 22 日的云栖大会现场,Qwen4 只占了一张幻灯片,上面写着 Coming Soon。没有参数,没有跑分,没有价格,没有日期。然后的一周里,“阿里要做 10 万亿参数大模型”满网飞。我把十几篇转载翻完,这个数越传越走样:有英文站写成 “5-10T tokens”,有中文号翻译成“5000 亿”,更多的直接把 10 万亿安在 Qwen4 头上,仿佛下个月就要开训。
先纠个偏:刘大一恒的原话里,5 到 10 万亿是 Qwen4.5 和 Qwen5 的规划区间,一个范围给两代模型用,官方没说哪个是 5 哪个是 10。Qwen4 本身,目前连一个能下载的文件都没有。
真正让我坐直的是那张幻灯片上的另外四个名字里的最后一个:Qwen4-27B。Max、Plus、Flash 都是 API,只有 27B 是给你下载回自己机器上跑的。一个 27B 凭什么和万亿参数的旗舰同桌点名?因为它是这条线上唯一“今晚就能开工”的入口。而且它背后藏着一个技术问题:如果新架构成立,“27B”这个名词的含义本身就要变了。
※ ※ ※
官宣只有名字,证据全在那个已经开源的预览版里
要判断 Qwen4 长什么样,不用等发布会。8 月底阿里干了件挺少见的事:把下一代架构装进一个能下载的模型,先扔出来让全世界踩。Qwen3.8-Flash-Next,模型卡上明写着“将支撑 Qwen4 的架构的实验性预览”。
它的参数账是这样的:主体 125B 稀疏 MoE,512 个路由专家、每 token 只激活 6B;外挂一张 51B 的 N-gram 嵌入表,2000 万条二元/三元组合,塞在 decoder 第 2 层;注意力用 Gated DeltaNet 和自家稀疏注意力 QSA 按 3:1 交替;训练优化器换成了 Muon。阿里给的数字:训练成本约上一代 397B 的 Plus 的九分之一,SWE-bench Pro 62.5,反超 3.8-27B 和 DeepSeek-V4-Flash。
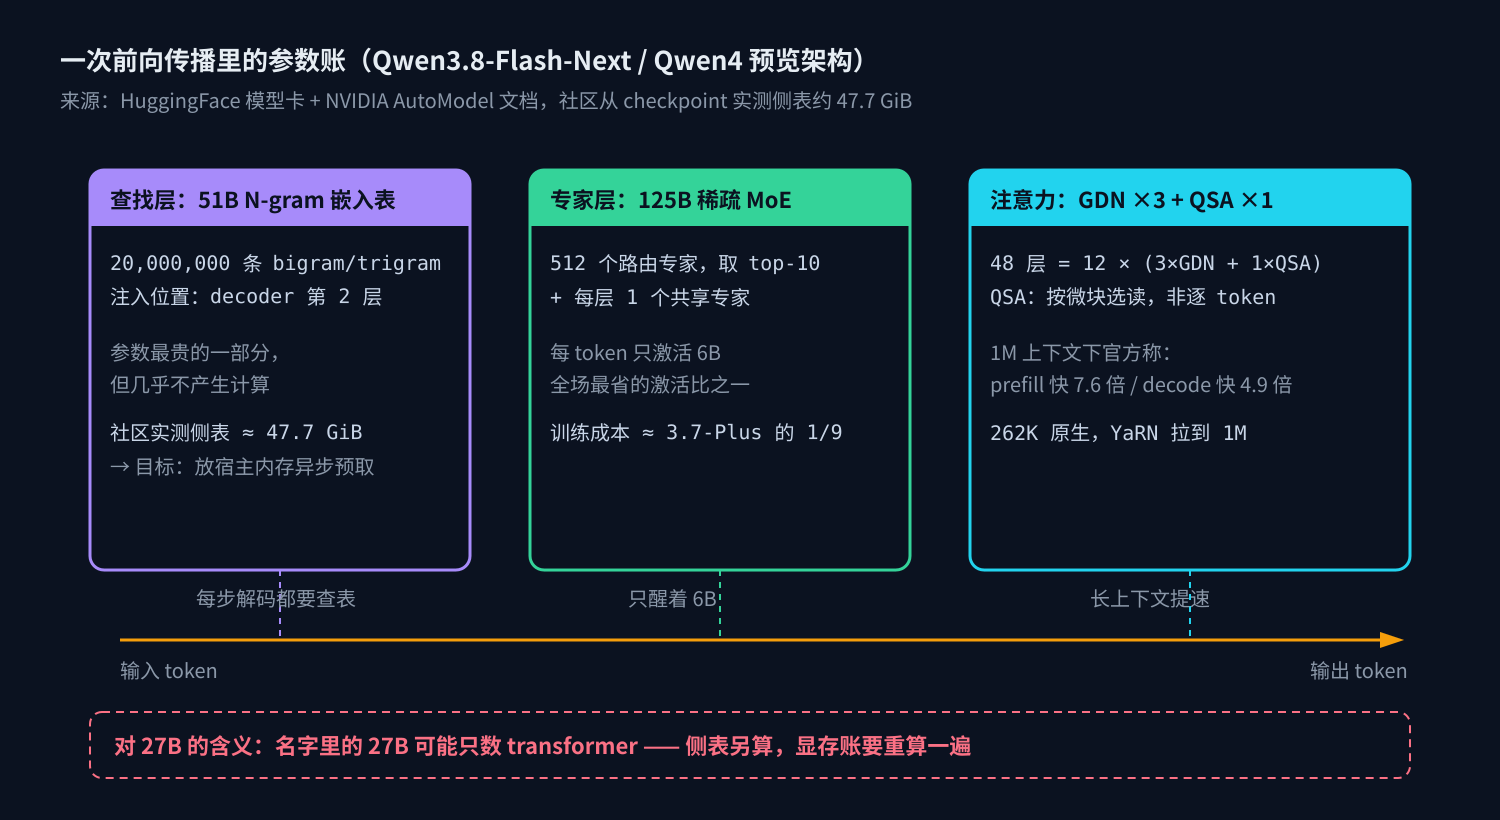
我盯上的是那张 51B 的表。行业这几年卷 MoE,本质是想“参数多、计算少”:专家摆一堆,每个 token 只叫醒一小撮。Qwen 这次更激进,把一半以上容量做成了查表。查表不产生多少计算量,放在宿主内存里异步预取就行,代价是要占住一大块 RAM。官方自己的说法翻译过来就是:这是条新的扩参数路线,比加专家便宜,比加显存友好。
要不要信这个设计?Flash-Next 就是拿来给社区验证的,vLLM、SGLang 8 月底当天支持,Unsloth 第二天给微调方案。快一个月过去,SGLang 仓库里针对这张表的 PR 还在一条条开。工程圈没散场,说明这题真有内容。
※ ※ ※
27B 的名字,可能不是你以为的 27B
现在回到那个最实际的问题:Qwen4-27B 出来,我那张卡跑不跑得动。
先看上一代怎么跑的。Qwen3.8-27B 是 dense 模型,BF16 权重约 54GB,一张 H100 端走;FP8 约 27GB,48G 的卡很舒服;4-bit 量化 16GB 左右,24G 消费卡落地,还留着写上下文的余量。24/48/80 这三档,就是本地党这几年的基准仓位。
但 Qwen4-27B 如果继承 Flash-Next 那套架构,账就不是这么算的了。r/LocalLLaMA 里有条高赞评论说得直白:“如果 Qwen 管新模型叫 27B,你该预期它是 27B 加 eXb——前提是他家也上 engram。” 名字里的数字可能只数 transformer 本体,N-gram 侧表另算。125B 加 51B 这个前车之鉴摆在那:标题参数和实际占用是两个数,社区拆 checkpoint 拆出来的侧表文件是 47.7 GiB,比很多人的显存都大。
这事坏一半、好一半。
坏的一半:显存规划要重算。47.7 GiB 每步解码都要查的表,塞在 96G 卡里就跟 KV cache 抢地盘,塞不进小卡就只能挪去内存——然后 PCIe 带宽决定你是 40 token 每秒还是 5 token 每秒。Reddit 上已经有帖子晒 Flash-Next 在各种“128G 统一内存小主机”上的跑分,从每 token 全走 GPU 到全靠内存预取,速度从两位数掉到个位数,量化再狠一点,4-bit 以下“不 great”是原话。
好的一半:查表参数天生比算参数好搬。MoE 专家卸载要过 GPU 互联,嵌入表挪到宿主内存只是慢一点,模型卡上的原话就包括“更适合显存受限硬件的卸载”。而且激活参数从 27B 掉到个位数 B 的话,正好治当前 27B 最大的毛病——慢。Qwen3.8-27B 托管 API 输出约 42 token/s,同档垫底,社区骂了一年,这几乎是最可以被新架构“顺手修掉”的短板。
还有个悬而未决的岔路:27B 会不会干脆留在 dense 路线,只把 QSA 和门控残差搬过来、不上 engram?目前没有任何官方线索。规划上,我建议按最坏情况留余量:卡按 dense 27B 配,RAM 按“可能多一块几十 GiB 的表”配。
※ ※ ※
日期、许可证,两件上线前要查的事
时间线。官方口径只有 September 22 日的“very soon”。可查的旁证有两条:一条是 3.8 代的节奏,8 月 3 日 Max 官宣,8 月 13 日 27B 权重上 Hugging Face,中间隔十天;照这个形状,Qwen4 的 27B 大概率跟着旗舰后一两周落地,不会同一天。另一条是预测市场,Qwen4 在 11 月 1 日前发布定价 74%。9 月 27 日 X 上传出内测截图,说前端编码约在 Opus 5.5 那一档、“27B 十月见”,但信源是匿名转帖、截图带贴吧水印,这条只当气氛参考,别当排期。把“very soon”读成“按周计,不是按季度”,我认为已经是当前信息下最激进的结论。
许可证。很多人默认“开源=Apache 随便商用”。3.8 一代刚打过样:27B 是 Apache 2.0,Max 是定制协议,Flash-Next 是 qwen-community-1.0——同一代,三张执照。阿里说 Qwen4-27B 开放权重,但执照没官宣。开放权重和宽松授权是两回事,准备商用打包的,权重落地第一件事是读 license 文件,别读 README。
※ ※ ※
那张 10 万亿的饼,画给谁的
最后把镜头拉回被传歪的那个数字,因为它说明了千问这条线真正在赌什么。
云栖同场发布的还有:递归自我改进 RSI 进了训练、推理、芯模协同环节,Qwen3.8-Max 在人类“零参与”下自迭代 33 轮、Artificial Analysis 得分从 40 拉到 45;平头哥真武 V900 芯片 216GB 显存、2027 年一季度量产;阿里云 2032 年数据中心容量目标 20GW。5 到 10 万亿参数,就放在这套“芯片、电力、自进化”的组合拳里,那是 API 和基建的生意,跟你的显卡没有直接关系。
有关系的是另一半姿态:一边把参数上限画到十万亿,一边在家族名单里给 27B 留了个和旗舰并列的位置。Qwen3.8-27B 9 月中成了 Hugging Face 历史上最受好评的开源模型,Perplexity、Airbnb 都在它的衍生生态里做事——这条线是千问全球影响力和议价权的底座。开源不是情怀,是卡位。27B 上不上 Qwen4,本质上决定了“本地能跑的最强开源模型”这个头衔 2026 年 Q4 花落谁家。
※ ※ ※
今晚能干的事
不用等官宣,动作都不亏。
把 Qwen3.8-27B 架起来,用你自己的提示词、你自己的评测集。Qwen4-27B 模型卡出现那天,唯一值得回答的问题是你的负载上它是不是更强,这问题没有基线就没法答。 serving 保持 OpenAI 兼容接口,到时候换模型就改一个字符串。量化路线先定:24G 卡走 4-bit GGUF 是成熟打法,3.8-27B 发布一两天内 llama.cpp/Ollama 的构建就有了,4-27B 大概率同样待遇;预算在 48G 以上,直接 FP8 等官方。
然后是那个我还没想清楚、留给你琢磨的问题:如果“27B”不再等于 27B,而是一部分住在显存、一部分住在内存、一部分住在 SSD 上,我们说了三年的“这卡能不能跑”,是不是该换成一个新问法了?评论区聊聊你想先看到哪个答案——Qwen4-27B 的模型卡,还是 35B-A3B 的复活。
作者:潇然
※ ※ ※
资料来源:阿里巴巴 2026-09-22 云栖大会官方发布及现场报道(IT之家/新浪科技/TechWeb)、Qwen 官方博客与 Hugging Face 模型卡(Qwen3.8-Flash-Next,2026-08-26/28)、NVIDIA NeMo AutoModel 模型文档、SGLang PR #40235、Yotta Labs Qwen4 追踪页(2026-09-22)、Reuters 2026-09-22、r/LocalLLaMA 与 r/LocalLLM 相关讨论帖(2026-09-22 至 09-30 检索)。文中第三方跑分均为厂商或社区自报口径,尚无独立复现;内测截图信息为传闻,已标注。检索时间 2026-10-01。
评论 (0)
登录 或 注册 后参与讨论。