[F4]你让AI写的小说,为什么一眼就被看穿?
2026-10-01 · AI 写作观察 · 作者:潇然 · 全文约 4300 字 · 阅读约 12 分钟
判断一句话有没有 AI 味,词汇表帮不了你。真正起作用的是问句底下那层东西:这句话是谁在说,站在哪个位置说,他知不知道后面会发生什么。
AI 写小说露馅,多半露在“仿佛”“深吸一口气”这类词之外:在句式骨架上,在段落关系上,在谁在说话这件事上。
※ ※ ※
🔍 先看一个让我停下来的句子
上个月帮朋友审一篇重生文的开头,模型产出的,平台检测工具给的分数很体面。但第一自然段我就划了线:
林晚不知道的是,这句随口答应下来的婚约,会在三年后毁掉她整个家族。
工具没报警。人一眼就看见了。这一句的问题是叙述者站起来说话了:他站在三年后,回头告诉读者“注意,这里有坑”。真实的人写回忆录才会这样说话,而网文的开头九十页里出现这种全知旁白,等于作者隔着纸冲你眨眼。
我把稿子里这类句子归拢了一下,发现 AI 味在小说文本里的落点高度集中:不在词,在句式的骨架上;不在单句,在段落和段落的关系上。这一篇就顺着这条线,把“一眼被看穿”拆到可操作的程度:哪些句式是重灾区、为什么detector式的查词表拦不住它们、以及一套我自己跑的去味流程,检测交脚本,改交给人。
※ ※ ※
🧠 AI 味的根:叙述人格错位
先立一个判断,后面所有例子都挂在它上面:
小说文本里,AI 味的本质是叙述人格问题。模型没有稳定的“谁在说话”意识,它是在模仿“写得好”的平均样式。
拆开说就是三件事:
- 视角越权。第三人称有限视角的小说,叙述者应该跟着主角走,主角不知道的,叙述者也不能说。但模型的训练语料里混着大量全知叙述、夹叙夹议的散文、甚至百科条目,它写着写着就飘到上帝位置上去了。“她不知道的是”这类句子就是这么漏出来的。
- 替读者定性。人写情绪是给证据:手在抖、茶凉了三次没喝。AI 写情绪是给判决书:“她心中涌起一股说不清的失落。”读者本来可以自己判断出失落,你替他判断了,文本就塌了一层。
- 为工整牺牲因果。“这不是告别,而是开始。”这种句子对仗工整,读着像金句,但它没有因果、没有信息,纯靠句式撑起来。人写小说十句里出一句这样的,正常;AI 三节出一句,就是指纹。
这三条在中文网络写作社区早就有说法,报幕腔、旁白剧透、金句炫技,叫法不一。这里不引任何具体作品和帖子,例子全部自造,你对着自己的稿子对号入座就行。
※ ※ ※
🪓 五个一眼露馅的句式骨架
我把最近经手的三十多万字 AI 网文稿扫了一遍,用确定性正则统计了句式命中密度(脚本收尾会讲思路)。下面这五类,命中率高、误判率低,是“一眼看穿”的主力。
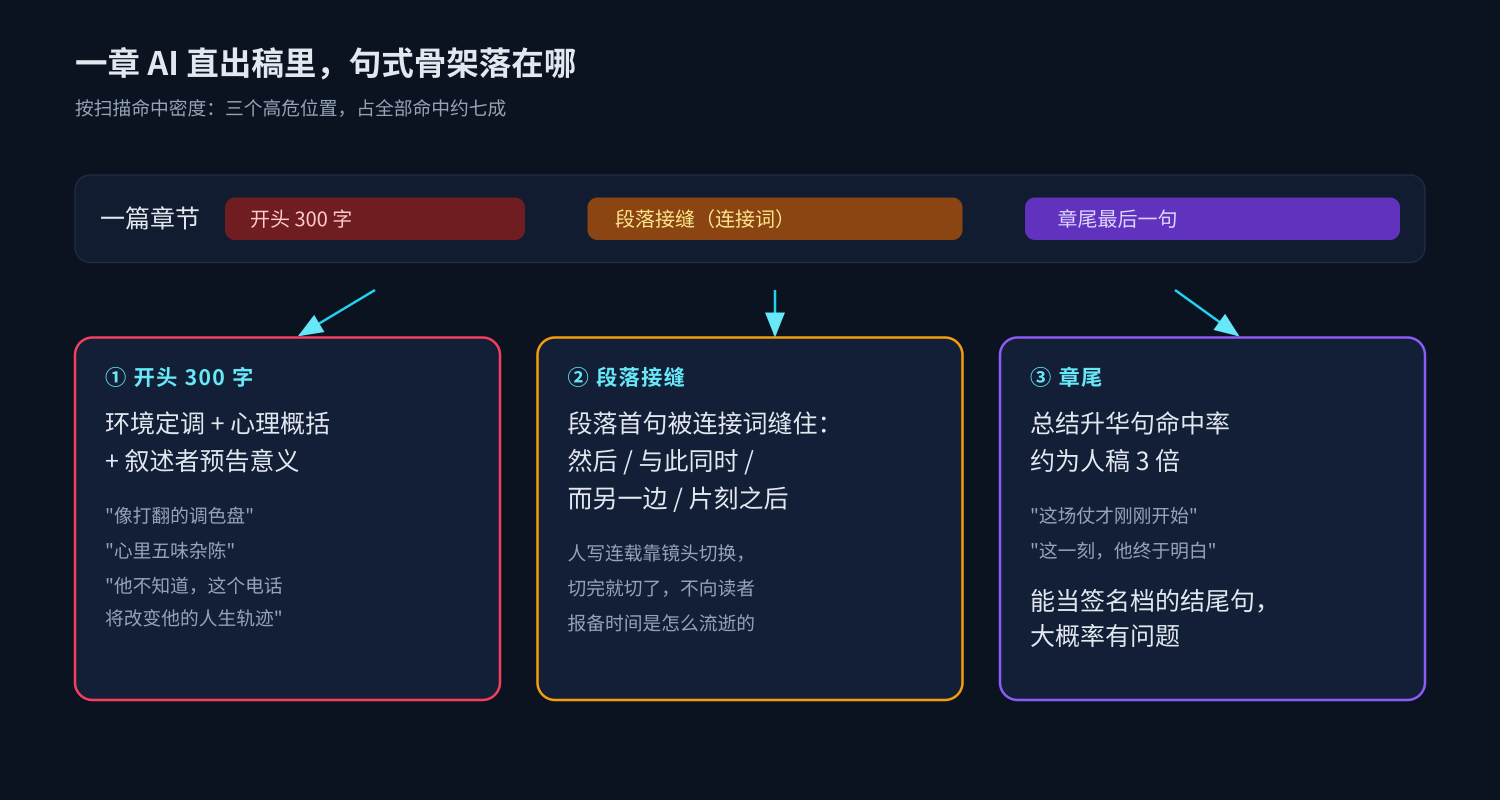
有一说一:这五个骨架人也会用。区别在密度和位置。人在关键节点用一次,是重拍;AI 在每一节的同一位置用一次,是模板。我统计里最扎眼的一个数字是,模型产出的章节末尾出现“总结升华式句子”的比例,大约是人稿的三倍。章尾是最容易露馅的位置,因为模型把“段落要收住”理解为“结尾要点题”。
※ ※ ※
🚫 为什么查词表的工具拦不住
市面上去 AI 味工具第一代是词表:仿佛、一丝、深吸一口气,命中就标黄。这个思路治标,原因有三层:
第一,词是活的。“仿佛”在口语化叙述里出现得很正常,番茄高分样本的语料统计里 像/好像/仿佛/如同 在三百多章样本中出现了两百多章。你把它们清零,文本反而不像人了,像体检报告。
第二,模型会绕。你把词表喂给它当负面清单,它换个句式照样输出一样的味道:“深吸一口气”没了,来了“呼吸停了半拍”。骨架没动,皮换了。
第三,也是最实在的:AI 味的读感来自节奏均匀。段落全是三到五行,句子全是同样的换气点,对话永远信息完整逻辑清晰,没有人在此刻说错话、漏真话、接不上茬。这些全是统计特征,你把任何一张词表翻烂也枚举不完。
所以我现在的流程里,机器只负责定位,不负责判决。
※ ※ ※
📉 平台已经把“被看穿”做成了生计问题
以前这事只影响口碑,现在直接影响签约。番茄小说今年 8 月的内容治理公示给了两个公开数字:单月拒绝签约低质书籍 16.3 万本,处置低质违规书籍 6.1 万本。公告里给下架理由用的原话,跟前面那张骨架表几乎逐条对上:“行文机械、文笔空洞”,“词藻堆砌、句式呆板,文字质感较差”。同一轮专项整治里,单日更新上百本的量产账号被永久封禁了 855 个。
这个信号值得所有用 AI 辅助写作的人琢磨:平台治理和你肉眼判断用的是同一批特征。它不需要给你的稿子贴“AI 生成”的标签,只需要按“句式呆板、词藻堆砌”的低质标准收掉它。换句话说,去 AI 味这件事正在从“骗过读者”变成“过审线”。你就算坚信自己的稿子是 AI 起稿人修七成,平台的编辑和巡查看到的成品里那些均匀节奏和对仗收尾,照样按低质处理。
※ ※ ※
🎬 前 300 字是最容易露馅的地方
编辑审稿有个行规:开头三百字定生死。机器文也一样,而且机器的破绽在前三百字里是成串出现的。我拿两段同一题材的开头做个对照,都是“小人物夜里被叫去加班”。
AI 直出的版本通常是这样的节奏:先一句环境定调(“城市的霓虹在雨里晕开,像谁打翻的调色盘”),再一句心理概括(“李默看着手机屏幕,心里五味杂陈”),然后叙述者接管,把今晚这件事的意义直接讲给你听(“他不知道,这个电话将改变他的人生轨迹”)。三段话,一个比喻,一个情绪判决书,一个剧透定调子,全是上面表里的骨架,密度高到可以当教学案例。
人写的版本大概率是什么样?是物件和动作先出来:“泡面吃到一半,钉钉响了。李默看了一眼群名,把筷子搁下,又拿起来把那口面吃完,才点开消息。”他为什么把面吃完才敢点开?这句话不解释,读者自己会补:怕看见的内容等得了一分钟。你看,这就是叙述人格的差别:AI 的开头急着告诉你“这件事很重要”,人的开头只给你一个动作,重要性藏在动作的反常里。
所以我把去味的第一道人工检查放在开头三百字,比通读全文效率高得多。三个问题问完基本就有数:这段里有没有一句在替读者定性?有没有一个比喻是任何题材都能原样搬走的(打翻的调色盘、揉皱的蓝天,全是这种)?叙述者有没有比主角先知道结局?
※ ※ ※
🛠️ 我的去味闸门:脚本定位 + 人工改,改最少改最准
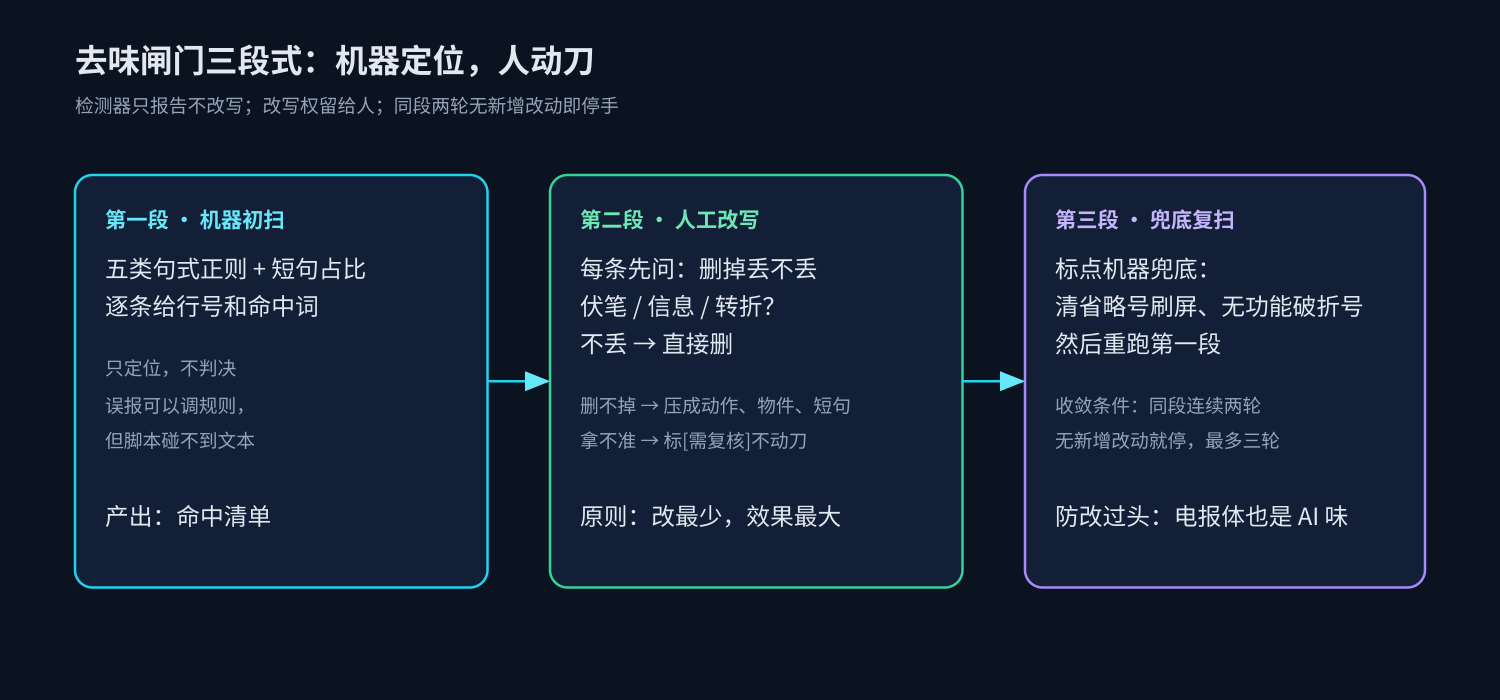
这是我实际在跑的三段式,跑通了再写进工作流,供参考。思路一句话:确定性检测打底,分级处理,改完必须复扫收敛。
第一段,机器初扫。核心逻辑不到四十行,谁都能抄走改规则,我把它贴在这:
#!/usr/bin/env python3
"""aiflavor_scan.py — 文本层 AI 味句式扫描器(只报告,不改写)"""
import re, sys

RULES = [
    ("R1", "否定翻转", r"不是[^。\n]{1,18}[,,](而|就|只)?是"),
    ("R2", "音量反差", r"声音不[大高][^。\n]{0,12}[,,](却|但)"),
    ("R3", "情绪套词", r"(眼中闪过|嘴角勾起|深吸一口气|不禁|缓缓开口)"),
    ("R4", "上帝剧透", r"(她不知道的是|殊不知|多年以后|仿佛预示着)"),
    ("R5", "总结升华", r"(这一刻[^。\n]{0,10}(终于|才)|才刚刚开始|注定(是|要))"),
]

def report(path):
    text = open(path, encoding="utf-8").read()
    for rid, name, pat in RULES:
        for m in re.finditer(pat, text):
            line = text[:m.start()].count("\n") + 1
            print(f"L{line:<4} [{rid} {name}] {m.group(0)}")
    sents = [s for s in re.split(r"(?<=[。!?\n])", text) if s.strip()]
    shorts = sum(1 for s in sents if len(s.strip("。!?\n")) <= 6)
    print(f"句数 {len(sents)};≤6字短句占比 {shorts/max(len(sents),1):.0%}")

for p in sys.argv[1:]:
    report(p)
跑在一章 AI 直出的草稿上,输出长这样(本机实跑,样本为自造段落):
L4    [R1 否定翻转] 不是冷漠,只是
L1    [R2 音量反差] 声音不大,却
L3    [R3 情绪套词] 眼中闪过
L3    [R3 情绪套词] 深吸一口气
L2    [R4 上帝剧透] 她不知道的是
L5    [R5 总结升华] 这一刻,他才
句数 6;≤6字短句占比 17%
拿这份命中清单当靶子逐条过,比通读十遍都有数。规则全是正则,误报可以调,但它只报告不改写。这一步我故意不让它碰文本,改写权留给人。
第二段,对照处理。按“改最少、效果最大”的原则过一遍,这里有一条我贴在屏幕边的删除优先判断:
每个命中先问三个问题:
1. 删掉这句,丢不丢伏笔/信息/转折?不丢 → 直接删,不润色。
2. 删不掉但会伤连贯 → 压成动作、物件或短句,别换成另一个形容词。
3. 疑似套路但拿不准 → 标记[需复核],不当场动刀。
改法给两个真实对照片段(都是自造例)。
否定翻转,删靶子写正文:
改前:他不是不想救她,他只是没有那个能力。
改后:他站在河边看了一夜,天亮时人已经没影了。他转身往回走。
第二个例子是把“心理告知”换回“身体证据”,但注意不是所有情绪都值得外化,低强度的过场直接写“他有点烦”就够了,每句都外化是另一种模板:
改前:她心中涌起一股说不清的失落,仿佛有什么东西碎掉了。
改后:她把手机放回口袋,又拿出来,屏幕还是黑的。
第三段,确定性收尾加复扫。标点机器兜底:清理残留的省略号刷屏、无功能破折号;然后重跑第一段,同一段连续两轮没有新增改动就停手,最多三轮。这个收敛条件是防止把文本改过头:我见过有人把稿子去味去成了电报体,通篇五字短句,那是另一种 AI 味。
※ ※ ※
📊 效果怎么验收
改完不吹感觉,做盲测。我的土办法很简单:同一情节,AI 直出稿和去味稿各抽三百字,隐去来源发给五个常看网文的朋友,问一句“哪段像机器写的”。样本小,结论别当科学,但方向和我前面的判断一致:句式闸门跑完之后,被猜中的比例明显下来了,最关键的下降来自章尾和第一自然段。
还有两个免费信号源,成本更低:一是章尾最后一句,如果它读起来能当签名档,大概率有问题,人在写连载时没空每章升华一次;二是对话,把台词单独抽出来连读,如果每句都信息完整、答到点上,全删了重写,真人的对话一半是答非所问。
还有一类检测器抓不到、人肉一眼能看见的位置:对话里的接茬。人跟人说话,一大半是接不住茬的。上一句问东,下一句答西;有人打断,有人重复对方的词,有人用“嗯”拖着一段对话不结束。AI 写的对话每一句都精准回应上一句的信息点,像两个客服在对账。我改对话有个笨办法:把台词单独抽出来连读,凡是每句都答到点上的章节,整段推倒重写,强制让三分之一的人在这一场里说废话、跑题、答非所问。改完念出声,磕巴的地方不用修,人说话本来就磕巴。
还有一个更隐蔽的信号藏在段落之间的接缝里。你去看 AI 稿子的段落首句,十有八九带连接词:然后、与此同时、而另一边、片刻之后。它是在用连接词缝段落,人写连载靠的是镜头切换,切完就切了,不需要向读者报备时间流逝。把段落首句的连接词删掉大半,文本立刻不像机器了,这个手段在实践里比换词表有效得多。
※ ※ ※
🎭 但管道治不了的那一半
写到这得泼自己一盆冷水。
上面全是形:句式、密度、节奏。去味管道能把你稿子里的“一眼假”降到“细看才假”,降不到零。因为最露馅的东西在情节层,而脚本扫不到情节。
模型写的故事有一种结构性的“礼貌”:冲突刚起来就有人递台阶,误会最多撑两章必解,坏人在关键节点一定会解释动机。它见过太多“大团圆收束”的文本,于是所有弧线都被它往完满了收。这跟句式没关系,你把“不是……而是……”杀干净了,那种处处妥帖的剧情照样一眼认出机器。人写的小说有烂尾、有写劈了的支线、有人物中途变心作者追不回来,这些“失控”恰恰是人味儿的一部分,也是生成模型在目标函数上被系统性消灭掉的东西。
所以我的结论不圆润,甚至有点扫兴:在可见的这几年里,AI 网文的可辨认度不会消失,只会移位。句式层的手段会像验证码一样互相卷,人肉检测的重心会一路从“词”退到“句”,再退到“事”,直到最后退无可退:你得靠“这个角色为什么非做这个选择不可”来验人。
那已经是编辑和作者的活了。脚本只能陪你走到这。
※ ※ ※
下一篇预告:拆完一个竞品小程序,我不写一行代码,倒推出了整本需求清单。
※ ※ ※
📚 资料来源
- ▪ 文中句式统计基于作者近期经手的约 30 万字 AI 生成网文稿的本地扫描结果,样本为个人工作稿,未公开;例句均为本文自造,不引任何真实作品
- ▪ 番茄高分样本语料统计(段落中位字数、“像/仿佛”出现章数占比等)转引自公开网文写作研究社区的样本口径,非作者实测
- ▪ 去味三段式流程(正则句式扫描 → 人工分级改写 → 标点兜底与复扫收敛)为作者本机实跑的自建脚本管道,检测器只报告不改写
- ▪ 盲测为作者邀请 5 位读者的非正式对照实验,无统计显著性,仅方向参考
- ▪ 生成日期:2026-10-01
评论 (0)
登录 或 注册 后参与讨论。